
BM25 算法是什么?和 TF-IDF 有什么区别?
下面是一段教学用的模拟面试。
🧑💻 面试官:RAG 为什么还会用 BM25?向量检索不是能理解语义吗?
🙋♂️ 我:BM25 按关键词相关性打分,型号、报错码这类明确词汇,用它检索往往更直接。
🧑💻 面试官:那一篇文档把关键词重复一百次,分数就一定最高吗?
🙋♂️ 我:不能只看词出现多少次,还要看词是否常见,以及文档有多长。
🧑💻 面试官:同一个词,在一份短说明和一本长手册里各出现两次,BM25 会怎样判断?它和 TF-IDF 的差别在哪里?
BM25 的三个抓手:这个词有没有区分度、重复出现还有多少收益、文档长度是否公平。
面试速答(60 秒版)
BM25 是一种关键词相关性评分方法。它会看查询词在文档里出现了多少次,也会看这个词在整个文档集合里有多常见。越少见、越有区分度的词,通常越有帮助。
和朴素地累计词频相比,BM25 对词频做了饱和处理。一个词从没出现到出现一次,信息增加很大;从九十九次变成一百次,就没必要继续大幅加分。它还会根据文档长度调整评分,避免长文只是因为内容多,就天然占便宜。
TF-IDF 是一类把词频和逆文档频率结合起来的表示或打分方法,具体实现有不同变体。BM25 则给出了更明确的词频饱和与长度归一化形式。
在 RAG 里,我会让 BM25 承担精确词汇检索,再按需要与向量检索融合。最后用真实问题验证召回和排序,不把某个分数当成“答案正确的概率”。
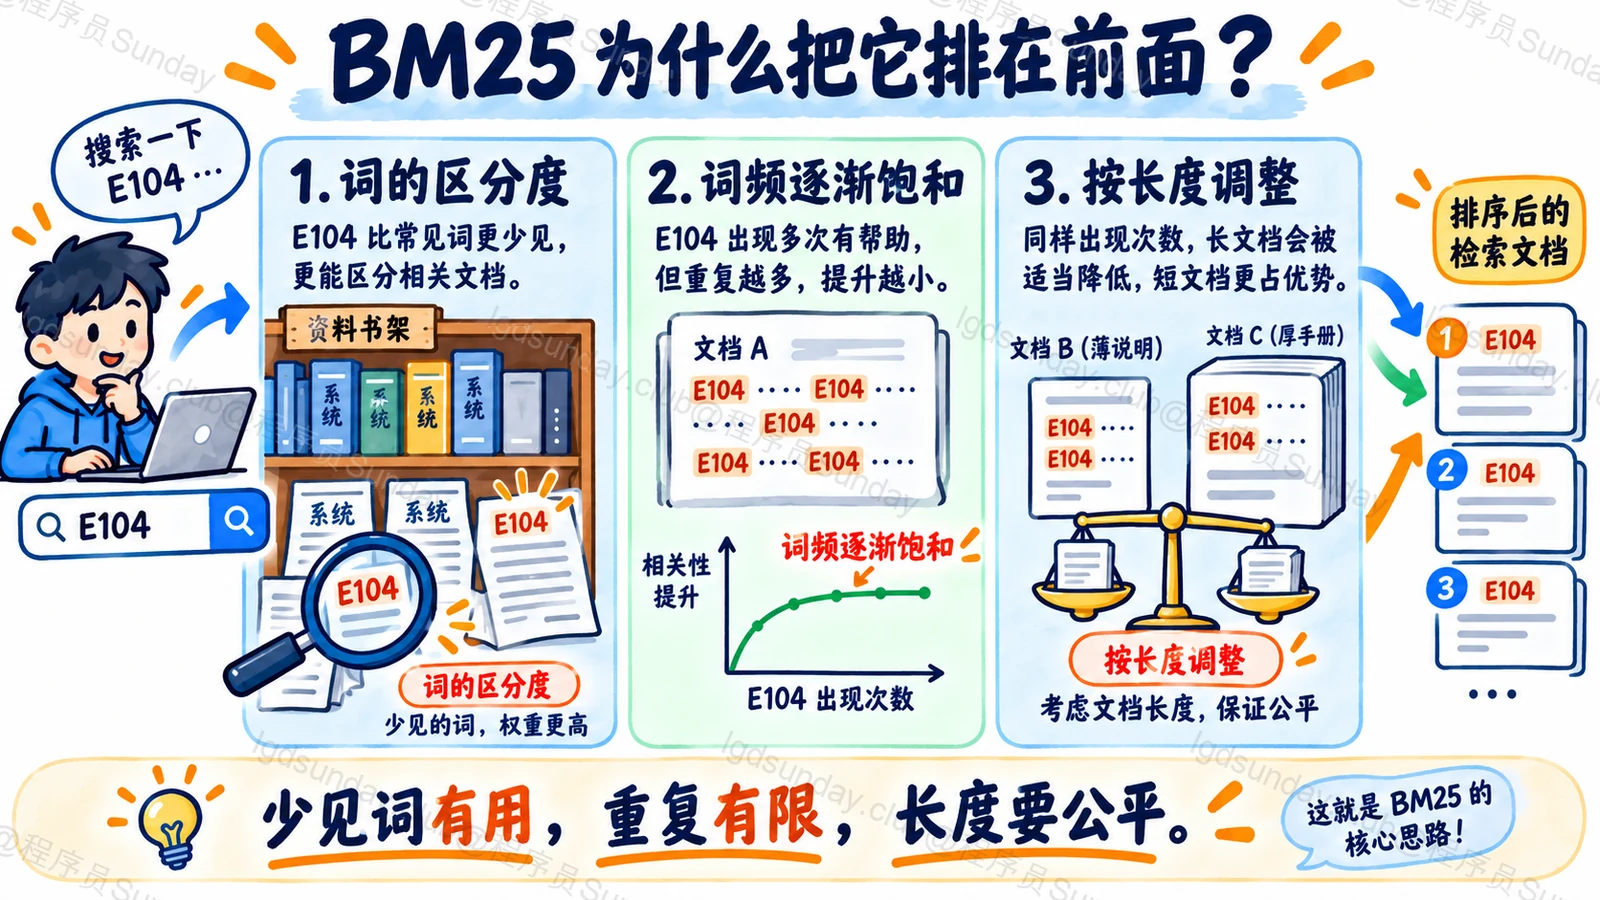
知识点详解:一个关键词,怎样影响文档排名?
先区分“出现次数”和“出现范围”
假设咱们要找一份介绍报错码 E104 的文档。
E104 在某一篇文档里出现三次,这是词频。另一个问题是:整个资料库有多少篇文档都包含 E104?这决定它能不能帮助我们区分不同文档。
如果几乎每篇文档都有“系统”这个词,搜索到它并不能缩小太多范围。E104 只出现在少数相关文档里,区分度就更高。
逆文档频率,也就是 IDF,表达的正是后面这层意思。不同实现的公式可能不同,不能把某一种 TF-IDF 公式当成所有系统的统一规则。
为什么词出现越多,收益却越来越小?
一篇文档第一次提到 E104,说明它可能相关;继续围绕 E104 展开,相关性也有支持。但重复贴几十遍报错码,不代表它能提供更多处理办法。
BM25 会让词频的加分逐渐趋于饱和。可以把它理解为一条先升得快、后来越来越平的曲线。
其中 k1 主要控制这种饱和速度。调大以后,较高词频可以继续贡献更多分数;调小以后,重复出现的额外收益更快减弱。参数怎么设,要结合文档和查询评测,不需要面试时背一组“万能值”。
长文为什么要做长度归一化?
假设短说明只有两百字,E104 出现两次;长手册有两万字,同样出现两次。
短说明很可能集中讨论这个错误。长手册里的两次出现,可能只是顺带提了一下。如果只数次数,这两份文档容易被当成差不多相关。
BM25 把文档长度和集合的平均文档长度进行比较,再调整词频贡献。参数 b 控制长度归一化的影响:b 为 0 时不做这项长度调整,b 越大,这项调整的影响越明显。
这里的长度通常按分词后的词项统计,并不是简单数汉字或字节。RAG 切片策略改变了文档单位,也会改变这些统计。
公式需要记到什么程度?
一种常见形式可以写成:
score(q, d) = Σ IDF(t) ×
  f(t,d) × (k1 + 1)
  / [f(t,d) + k1 × (1 - b + b × |d| / avgdl)]
求和针对查询词。f 是词频,|d| 是文档长度,avgdl 是平均长度。
公式里最重要的关系,是词频在分子和分母里同时出现,因此不会一直线性增长;长度比值则进入分母,对词频贡献做调整。实现的具体 IDF 形式、分词和统计范围,还要看检索系统,参考 Elastic 对 BM25 变量的说明。
面试中能把这三个关系讲明白,比只把公式写完整更有价值。
用在 RAG 时,还要检查什么?
先检查分词。型号被拆开、报错码被过滤,后面再调 k1 也很难补救。中文分词、专有名词、字段权重,都要结合资料检查。
再看查询是否真的包含关键字。用户说“登录一直转圈”,资料写的是“认证回调超时”,纯词项匹配未必能关联起来;这时向量检索或查询改写可以补充。
融合时也不能直接把两个原始分数相加。BM25 分数和向量相似度不是同一种尺度,可以使用经过验证的归一化方法,或者按名次融合。然后分别检查检索是否拿到证据,以及最终回答有没有正确使用证据。
面试官继续追问
BM25 分数 12,就比另一个问题的分数 8 更可靠吗?
不能跨不同查询直接这样解释。查询词、文档集合和打分配置都可能不同,分数更不是概率。应在明确的查询与评测设置下比较排序效果。
切片越短,BM25 就越好吗?
不一定。切得太短可能丢掉关键词之间的关系,甚至只留下一个报错码。要同时考虑词项匹配、上下文完整性和后续生成需求。
BM25 能替代向量检索吗?
精确词汇任务可以优先使用它;语义表达变化较大的问题,可能需要向量检索。二者是否组合,要看各自补到了哪些漏检,而不是因为“混合检索”听起来更先进。
面试速记卡
- TF 看文档里的词频,IDF 看词在集合中的区分度。
- BM25 对词频做饱和,重复出现不会无限线性加分。
- 长度归一化比较文档长度与集合平均长度。
- k1 影响词频饱和,b 影响长度调整。
- 分词、切片和真实评测,比背默认参数更重要。
- BM25 分数不是答案正确率,也不能随意和向量分数相加。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
虾皮 · Agent开发 · 秋招(原帖标签)
BM25 的计算原理是什么?(题意整理)
虾皮Agent一面 ↗
原帖记录 9 月 3 日面试,未明确年份