
Python 多进程怎么共享数据?普通 dict、Manager 和 shared_memory 有什么区别?
下面是模拟面试对话,用来讲解本题,不是真实面经。
🧑💻 面试官:多进程里修改普通 dict,父进程能看到吗?
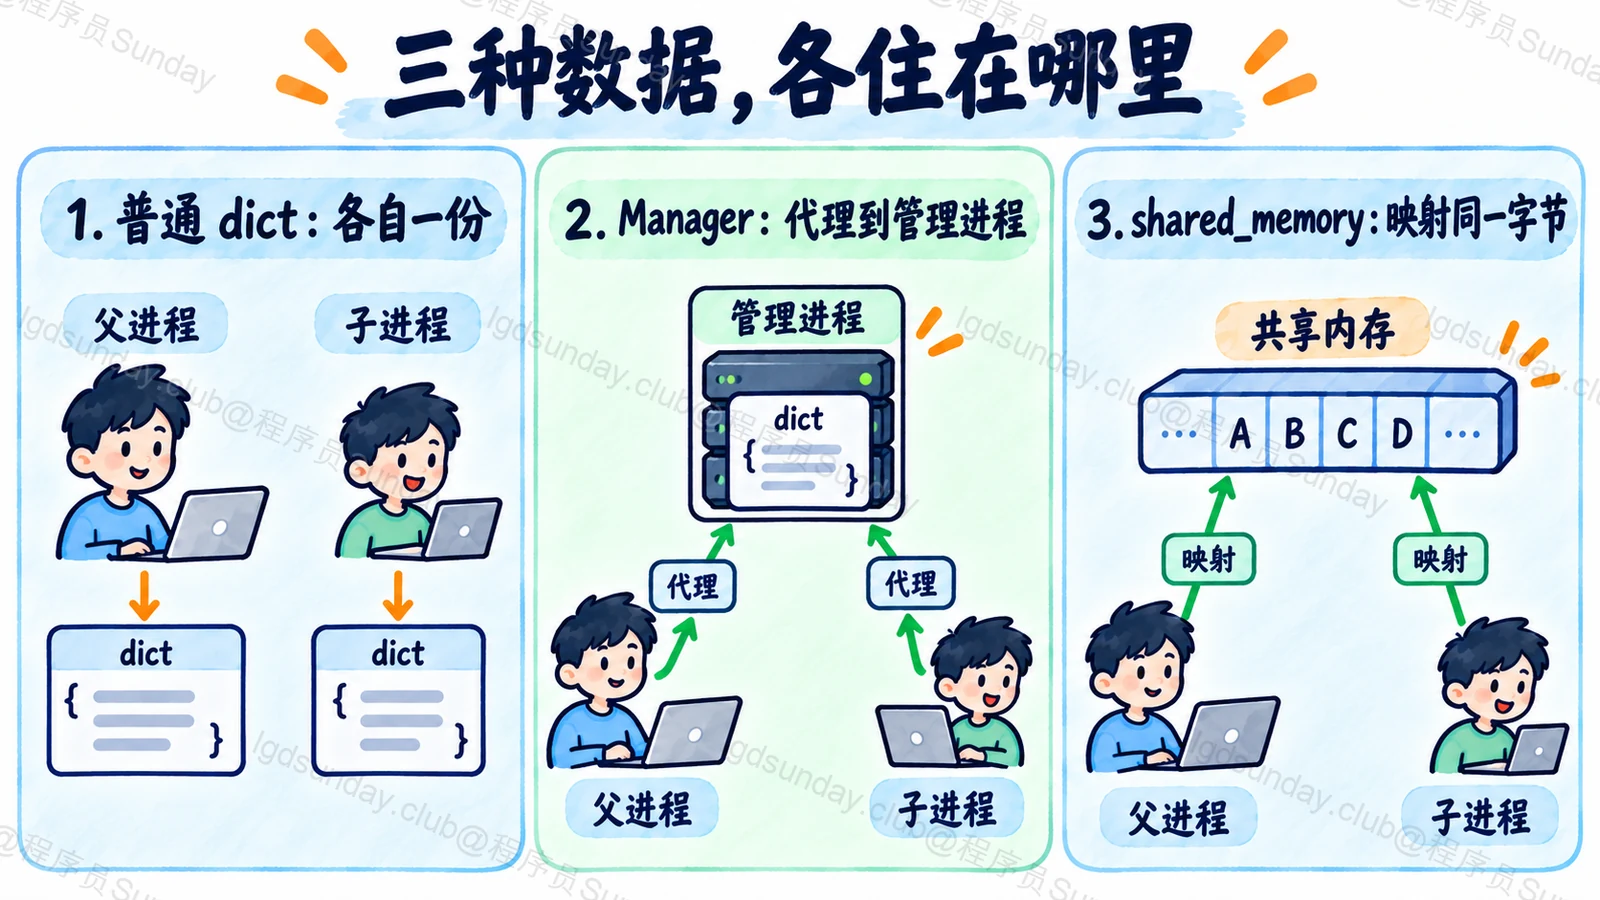
🙋♂️ 我:通常看不到,父子进程各有自己的对象状态。
🧑💻 面试官:那 Manager.dict 为什么能看到?
🙋♂️ 我:因为访问通过代理到管理进程里的对象。
🧑💻 面试官:shared_memory 是否就是不用序列化的共享字典?多个进程同时加计数又会安全吗?
看起来像字典,不代表数据就在当前进程里。代理对象和共享字节区,需要用两张不同的存储图来解释。
面试速答(60 秒版)
普通 dict 在不同进程里不会自动成为共同可写状态。spawn 会重建环境,fork 后的普通对象修改也通常各自独立。
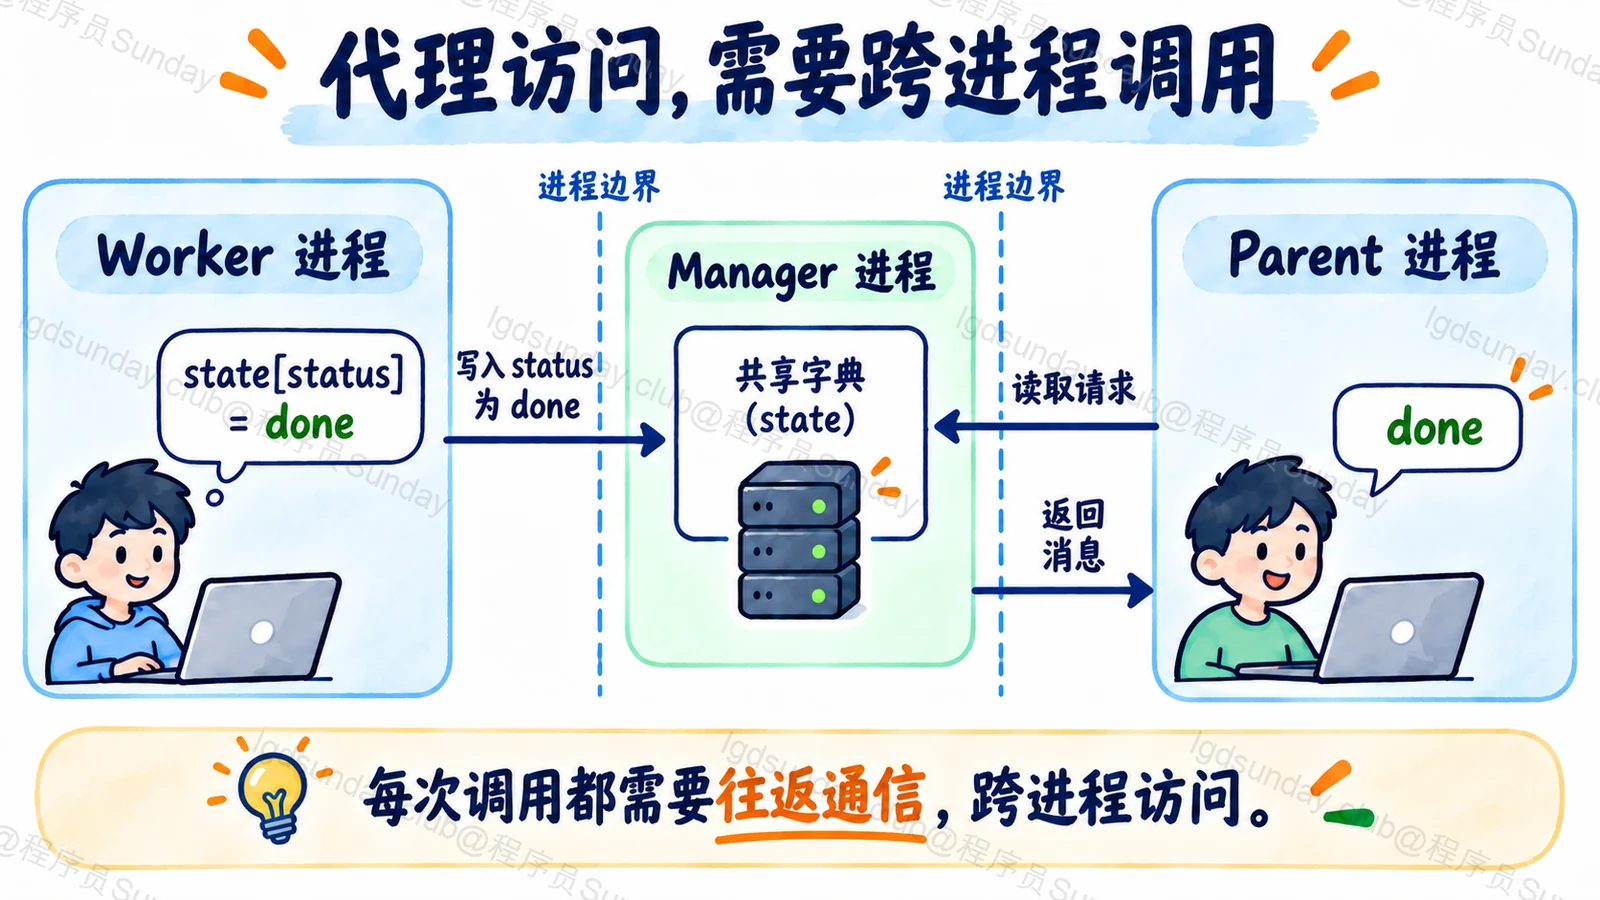
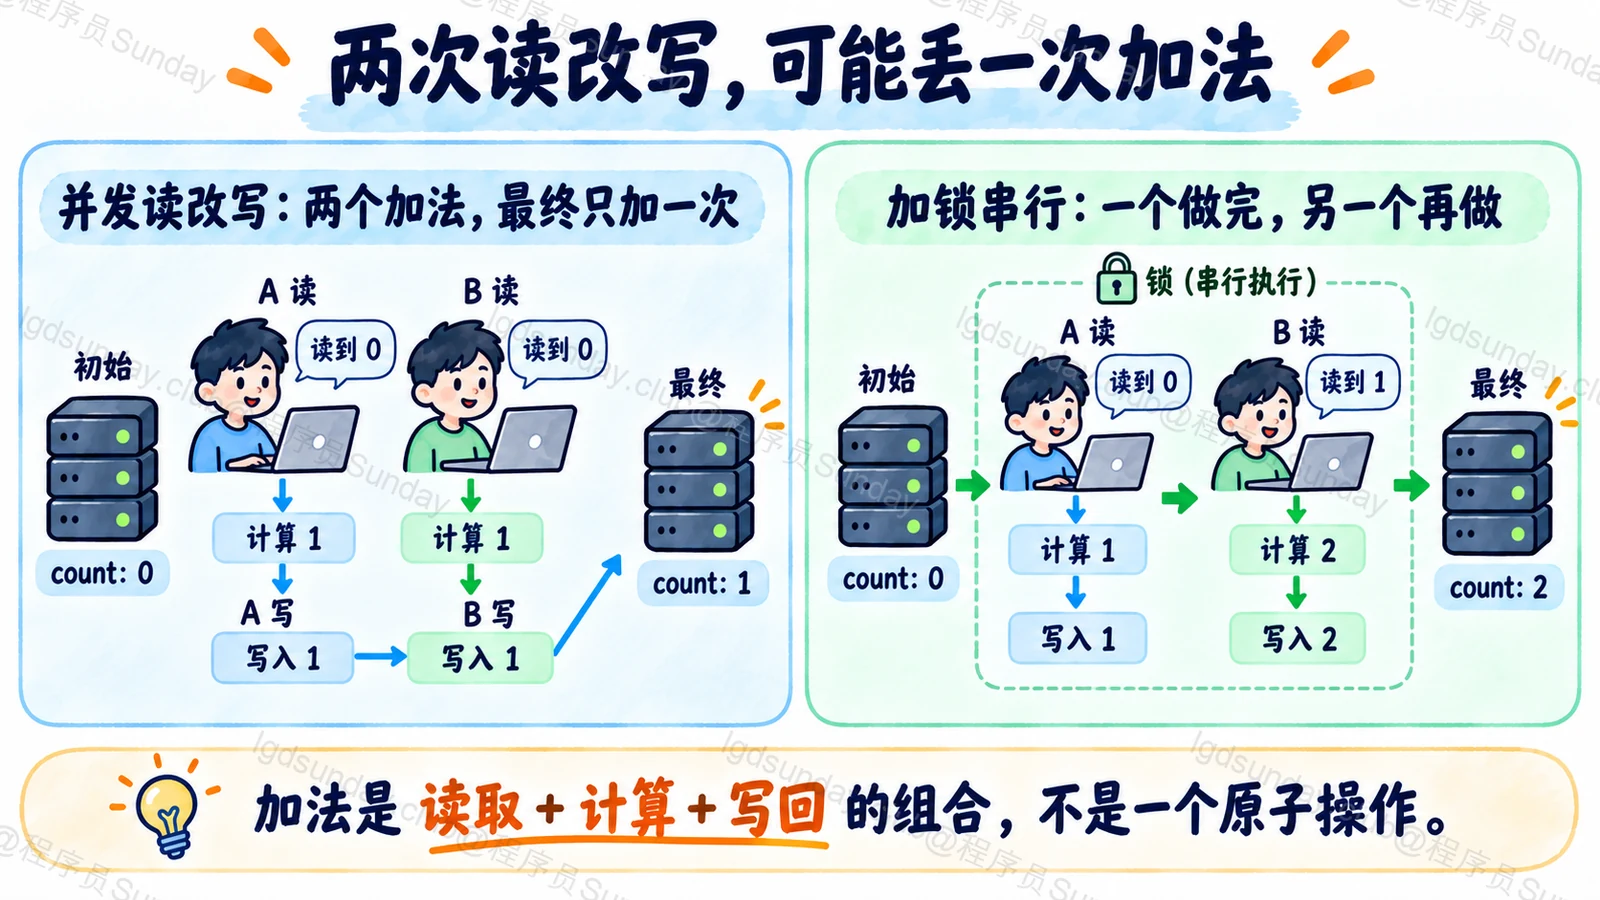
Manager 提供代理,通过进程间调用访问管理进程里的对象。它方便共享列表、字典等,但访问有通信和序列化成本,多个读改写组合也不自动原子化。
shared_memory 提供的是共享字节区。进程通过名字连接到同一块区域,怎样编码数据、保存形状和类型、同步读写,都要应用自己或上层库安排。它不是一个自动共享的 Python dict。
选择时,少量协调状态可以考虑 Manager;大块规则数据可以考虑共享内存。资源还要明确谁 close、谁 unlink,以及进程失败后怎样避免残留或提前删除。
知识点详解:复制的对象、远程代理和共享字节区
普通对象先归各自进程所有
假设父进程有状态字典,子进程把 status 改成 done。父进程不一定会看到变化,因为子进程操作的不是一份跨进程统一的 Python 字典。
fork 初始时两边内容相似,仍不能据此推断后续修改共享。spawn 更明确地建立自己的解释器环境。需要把结果交回父进程,可以发消息;需要共同可见的状态,再选共享机制。
不要先把所有对象都改成 Manager。很多计算只需要输入和最终输出,消息交接可能更容易确定所有者,也减少共享状态。
Manager 的字典,实际由代理访问
下面保存成独立脚本运行。子进程拿到代理,通过它修改管理进程维护的字典,父进程随后从代理读取。
Python
import multiprocessing as mp

def update(state):
    state["status"] = "done"

def main():
    context = mp.get_context("spawn")
    with context.Manager() as manager:
        state = manager.dict(status="pending")
        process = context.Process(target=update, args=(state,))
        process.start()
        process.join()
        if process.exitcode != 0:
            raise RuntimeError("子进程失败")
        print(state["status"])  # done

if __name__ == "__main__":
    main()
state.get、赋值等都可能涉及远程调用。state[“count”] += 1 包含读取和写回,多个进程同时做时不能靠“用了 Manager”就保证不丢更新。可以在共同锁下完成组合动作,或让一个所有者集中处理。
shared_memory 共享的是连续字节
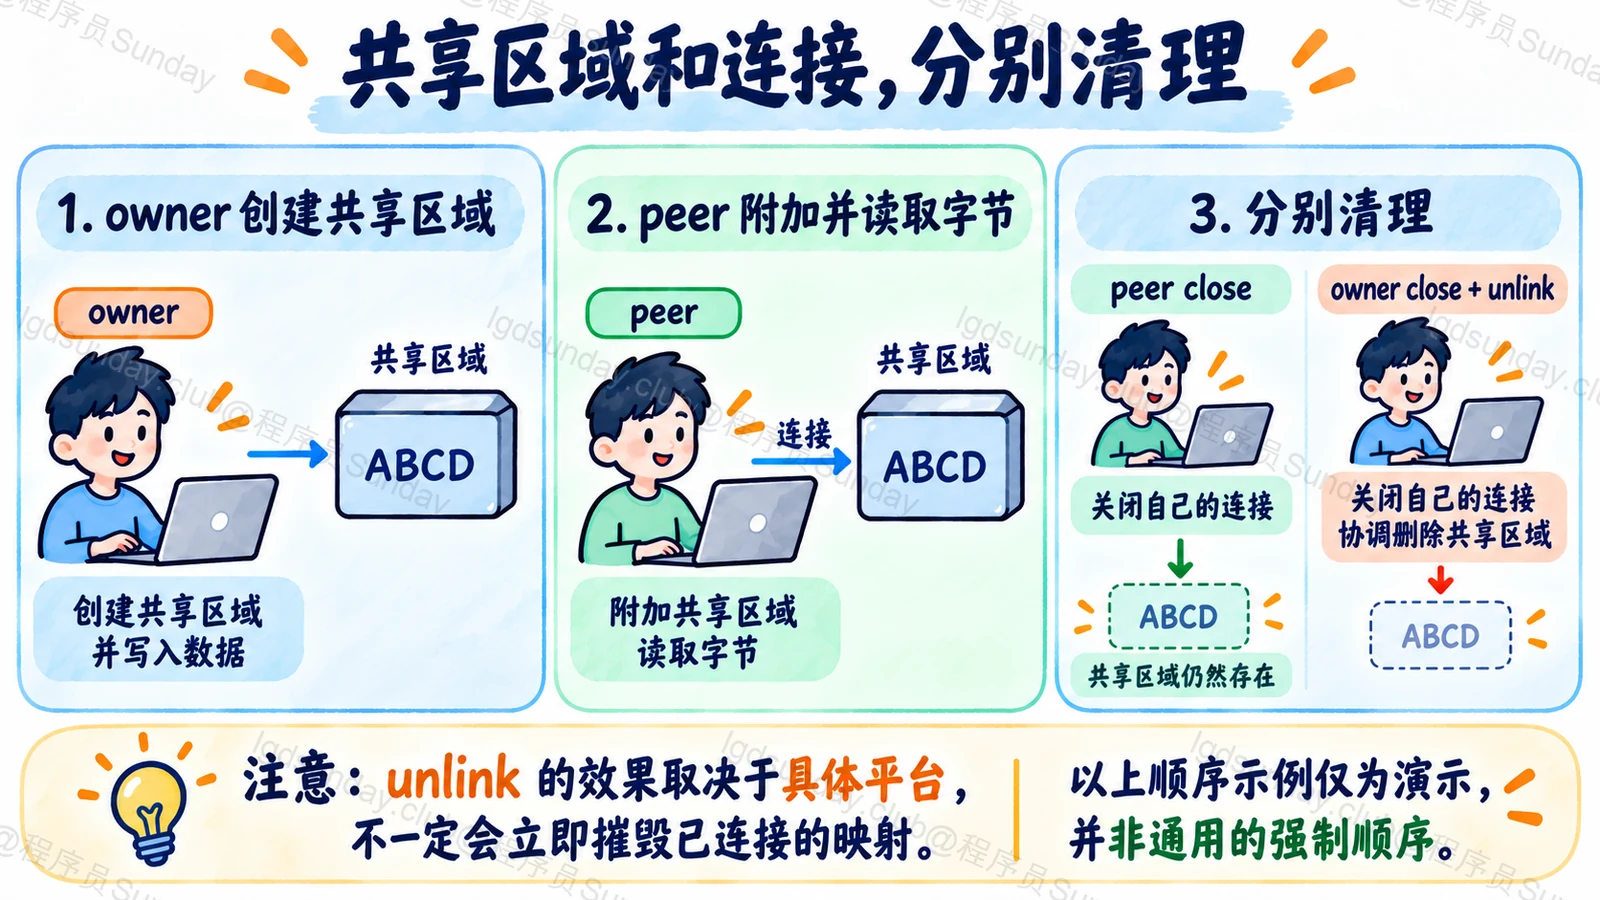
一个进程创建区域,把名字交给其他进程;其他进程用名字连接,看到同一份字节。至于这些字节代表整数、图片还是数组,需要约定格式。
下面用同进程两次连接展示它们确实指向同一块区域。真正跨进程时,同样把名字而不是 Python 字典传过去。
Python
from multiprocessing.shared_memory import SharedMemory

owner = SharedMemory(create=True, size=4)
peer = SharedMemory(name=owner.name)
try:
    owner.buf[:4] = b"ABCD"
    print(bytes(peer.buf[:4]))  # b'ABCD'
finally:
    peer.close()
    owner.close()
    owner.unlink()
这里没有自动同步。两个进程修改同一区域时仍要设计互斥、版本或分区,避免读到半次更新。close 关闭当前连接,unlink 负责删除共享资源的名字或安排销毁,具体平台行为有差异。
成本和生命周期一起选
TypeScript(共享字节与原子访问对照)
const storage = new SharedArrayBuffer(4);
const view = new Int32Array(storage);
Atomics.store(view, 0, 1);
Atomics.add(view, 0, 1);
console.log(Atomics.load(view, 0)); // 2
SharedArrayBuffer 通常用于 JS worker 的共享内存,不等于 Python 跨进程 Manager。这里用 Atomics 明确说明共享存储和同步操作是不同组件,不能只因为两边都叫共享就互换生命周期 API。
共享内存适合大块规则数据,但仍需额外保存长度、类型等信息。Manager 更容易表达小型对象结构,但频繁细粒度访问可能带来大量通信。实际测量应该同时看数据量、调用次数和复制成本。
Python 3.13 新增 track 等选项,独立进程与资源跟踪器的关系也要按版本确认。本文示例按 3.11 验证,不把新参数放进旧代码;测试收尾后应确认资源不能被再次正常附加,避免留下共享内存。
依据:Python 3.11 Managers、SharedMemory、Python 3.13 资源跟踪参数、ECMAScript Atomics。
面试官继续追问
Manager dict 里的普通列表 append 会同步吗?
如果取出的只是普通值,原地改它不一定回传。可使用嵌套代理,或明确把修改后的值重新赋回,按实际代理合同处理。
共享内存是不是没有复制?
它能避免部分跨进程数据复制,但创建输入、编码、读出副本等环节仍可能复制,不能对全流程作零复制保证。
close 和 unlink 谁做?
每个使用方关闭自己的连接,由明确所有者协调删除共享资源。不要多个进程在还需要访问时各自随意删除。
面试速记卡
- 普通 dict 不会自动成为跨进程共享状态。
- Manager 代理通过通信访问管理进程对象。
- 代理的多步读改写不自动原子化。
- shared_memory 提供字节区,格式与同步需安排。
- 连接关闭和资源删除各有明确所有者。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →