
LangGraph 的 RetryPolicy 怎么用?节点失败后如何安全重试?
下面是一段用于讲题的模拟面试对话。
🧑💻 面试官:LangGraph 节点调用资料接口失败了,你会怎么处理?
🙋♂️ 我:可以给节点配置 RetryPolicy,对暂时性的错误做有限重试。
🧑💻 面试官:max_attempts=3,是第一次失败后再重试三次吗?
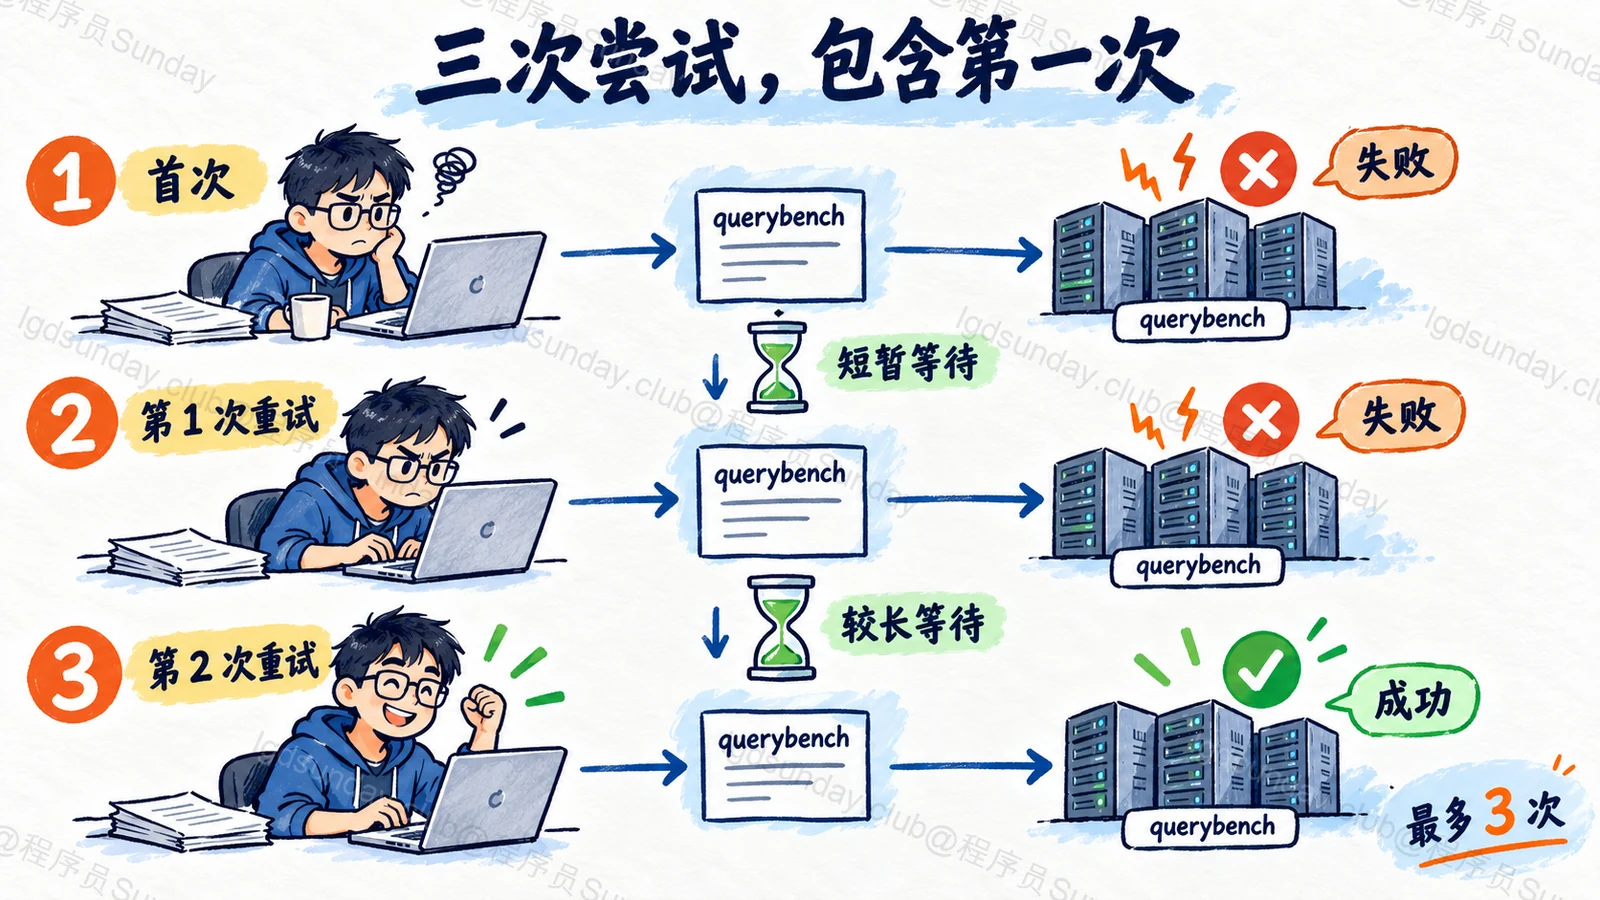
🙋♂️ 我:不是,它包含第一次调用,总共最多尝试三次。
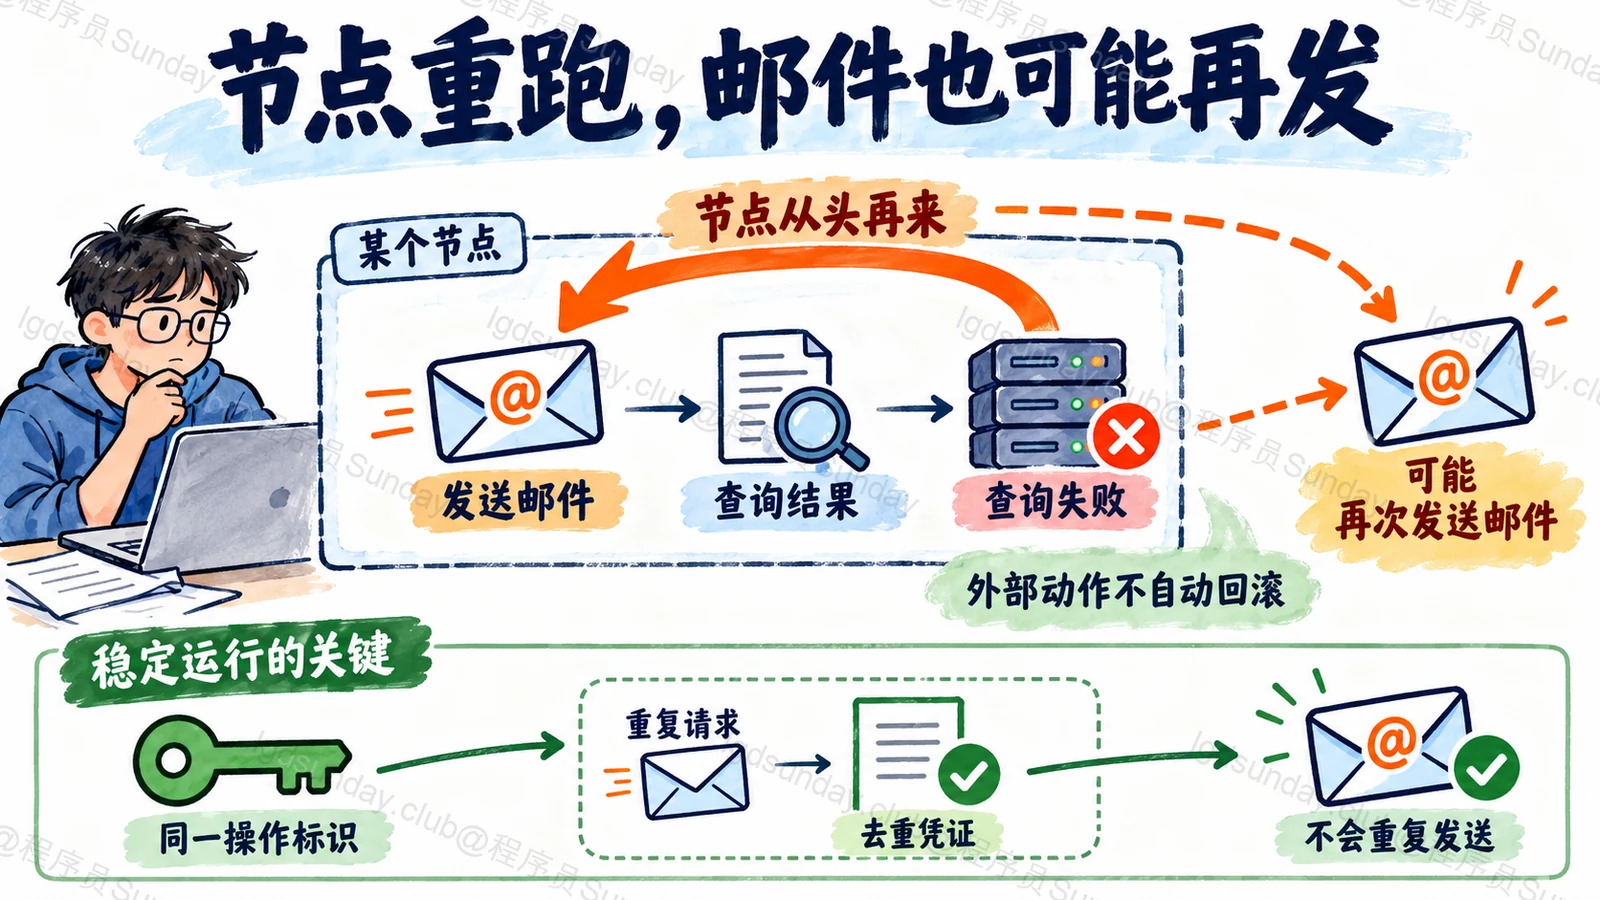
🧑💻 面试官:如果这个节点先发了一封邮件,接着查询接口失败,重试时会从查询接口那一行继续吗?
重试的对象是节点尝试,不是某一行代码;先确认哪些动作会重新发生,再谈重试次数。
面试速答(60 秒版)
RetryPolicy 用来控制 LangGraph 节点失败后是否再次执行,以及尝试次数和等待间隔。Python 在 add_node 里配置 retry_policy,TypeScript 则使用 addNode 的 retryPolicy。
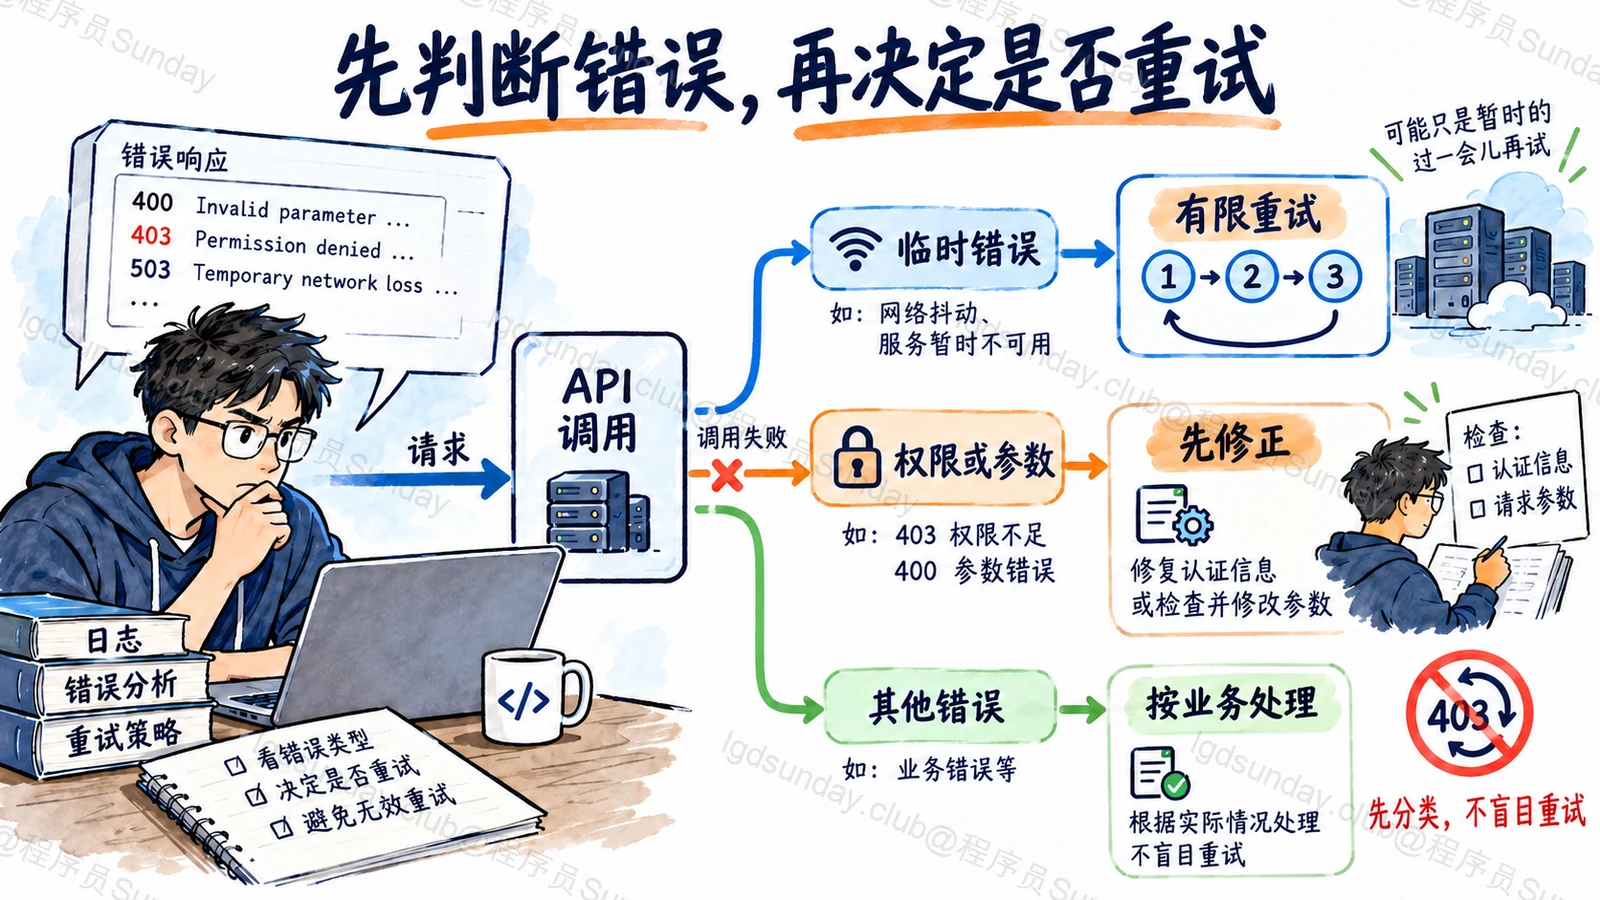
实际配置时,先区分错误。临时网络失败可以按条件重试,参数错误、权限不足通常要修改请求或停止。不要把所有异常都重试三遍,再把重复失败包装成稳定性。
次数包含第一次尝试,等待时间还可以配置退避和随机抖动。要注意两种语言的时间单位,Python 用秒,JS 用毫秒。
更重要的是,失败以后通常会重新执行节点函数,已经在外部发生的动作不会自动回滚。因此,查询与写入最好拆清楚;必须重试的写操作,要使用稳定的幂等标识,并能够核对第一次是否成功。
知识点详解:错误能不能靠再试一次解决?
先区分“暂时拿不到”与“请求本身不成立”
假设节点要读取资料。一次短暂的连接失败,再试一次可能成功;资料 ID 根本不存在,重复同一个请求通常只会得到同一个结果。
所以,重试策略要与工具契约一致。哪些错误表示暂时不可用,哪些表示参数需要修改,应该由应用明确分类。不能只根据错误消息里有没有“失败”两个字判断。
LangGraph 自带默认错误判断,但 Python 与 JS 的默认排除规则并不完全相同。项目中有重要边界时,直接写清楚自己的 retry_on 或 retryOn 更容易审查。两边规则分别见Python 容错文档和JS 容错文档。
用一个假错误,把尝试次数跑清楚
下面不连接真实网络,前两次故意抛出同一种暂时性错误,第三次返回结果。它验证的是节点重试机制,不能证明真实接口具备幂等能力。
import { Annotation, StateGraph, START, END } from "@langchain/langgraph";

class TransientError extends Error {}
const State = Annotation.Root({ answer: Annotation<string>() });
let calls = 0;

const graph = new StateGraph(State)
  .addNode("lookup", () => {
    calls++;
    if (calls < 3) throw new TransientError("temporary");
    return { answer: "ok" };
  }, {
    retryPolicy: {
      maxAttempts: 3,
      initialInterval: 1, // 毫秒,仅用于本地实验
      jitter: false,
      retryOn: error => error instanceof TransientError,
    },
  })
  .addEdge(START, "lookup")
  .addEdge("lookup", END)
  .compile();

async function main() {
  console.log(await graph.invoke({})); // { answer: "ok" }
  console.log(calls); // 3,包含第一次尝试
}
main();
from typing import TypedDict
from langgraph.graph import StateGraph, START, END
from langgraph.types import RetryPolicy
class State(TypedDict):
answer: str
class TransientError(Exception):
pass
calls = 0
def lookup(state):
global calls
calls += 1
if calls < 3:
raise TransientError("temporary")
return {"answer": "ok"}
graph = (
StateGraph(State)
.add_node("lookup", lookup, retry_policy=RetryPolicy(
max_attempts=3,
initial_interval=0.001, # 秒,仅用于本地实验
jitter=False,
retry_on=TransientError,
))
.add_edge(START, "lookup")
.add_edge("lookup", END)
.compile()
)
print(graph.invoke({})) # {'answer': 'ok'}
print(calls) # 3本次在 JS LangGraph 1.5.0、Python LangGraph 1.2.15 中实际验证了三次尝试与最终结果。示例把等待缩短并关闭抖动,是为了测试方便,不能照搬成生产重试参数。
为什么不能把整个大节点放心重试?
假设节点先发邮件,再查资料。邮件发送成功,查询失败,节点整体重新执行时,发送邮件这一步也可能再次发生。
框架可以清理失败尝试未提交的状态更新,却不能撤回已经送达的邮件。对退款、建单等操作也是一样,远端系统不属于 LangGraph 的状态事务。
比较容易维护的做法,是拆小有副作用的步骤,并让写接口接受固定的业务操作 ID。这个 ID 要代表同一笔业务动作,不应该每次重试都重新随机生成,否则远端会把它们当成不同操作。
次数有限,不代表总耗时就受控
三次调用,每次都卡很久,总耗时依然可能超出用户能接受的范围。除了次数,还需要单次调用超时、总任务预算,以及并发限流。
退避减少连续打满服务的压力,随机抖动避免大量任务在同一时刻一起重试。至于应该等多久,要结合上游限流规则与任务时限决定,不能因为示例写了一个数字就全项目统一。
面试官继续追问
模型正常返回了一个错误答案,会自动触发 RetryPolicy 吗?
不会仅凭内容错误自动触发。需要由验证步骤识别失败,再通过明确的异常或路由策略处理。反复重新生成也不一定改善事实错误,还可能只是增加成本。
重试用完以后怎么办?
可以让错误上抛,也可以按版本能力配置错误处理节点或处理器,返回降级结果、转人工或记录失败。降级结果必须标明未完成,不能为了流程继续就伪装成功。
401 和 429 能用同一种处理吗?
通常不能。401 要先检查凭证与授权;429 则需要结合限流策略、等待提示与预算决定是否再试。不要把 HTTP 状态码处理完全交给通用异常捕获。
面试速记卡
- max_attempts/maxAttempts 包含第一次执行,不是额外重试次数。
- Python 重试间隔用秒,JS 用毫秒。
- 先分类错误,再设置有限重试、退避与抖动。
- 重试会重新执行节点,外部动作不会自动回滚。
- 写入要有稳定幂等标识,次数之外还要限制超时与总预算。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →