
Go pprof 怎么用?CPU、堆内存和 goroutine profile 分别看什么?
以下是一段用于讲解的模拟面试对话。
🧑💻 面试官: Go 服务响应慢了,你会拿什么性能资料?
🙋♂️ 我: 用 pprof,看看火焰图里哪个函数最宽。
🧑💻 面试官: CPU 很空闲,但很多请求都在等待数据库,这时 CPU profile 会直接告诉你等待了多久吗?
🙋♂️ 我: 那可能要看 goroutine。
🧑💻 面试官: 内存曲线升高时,应该看当前还活着的对象,还是历史一共分配过多少?
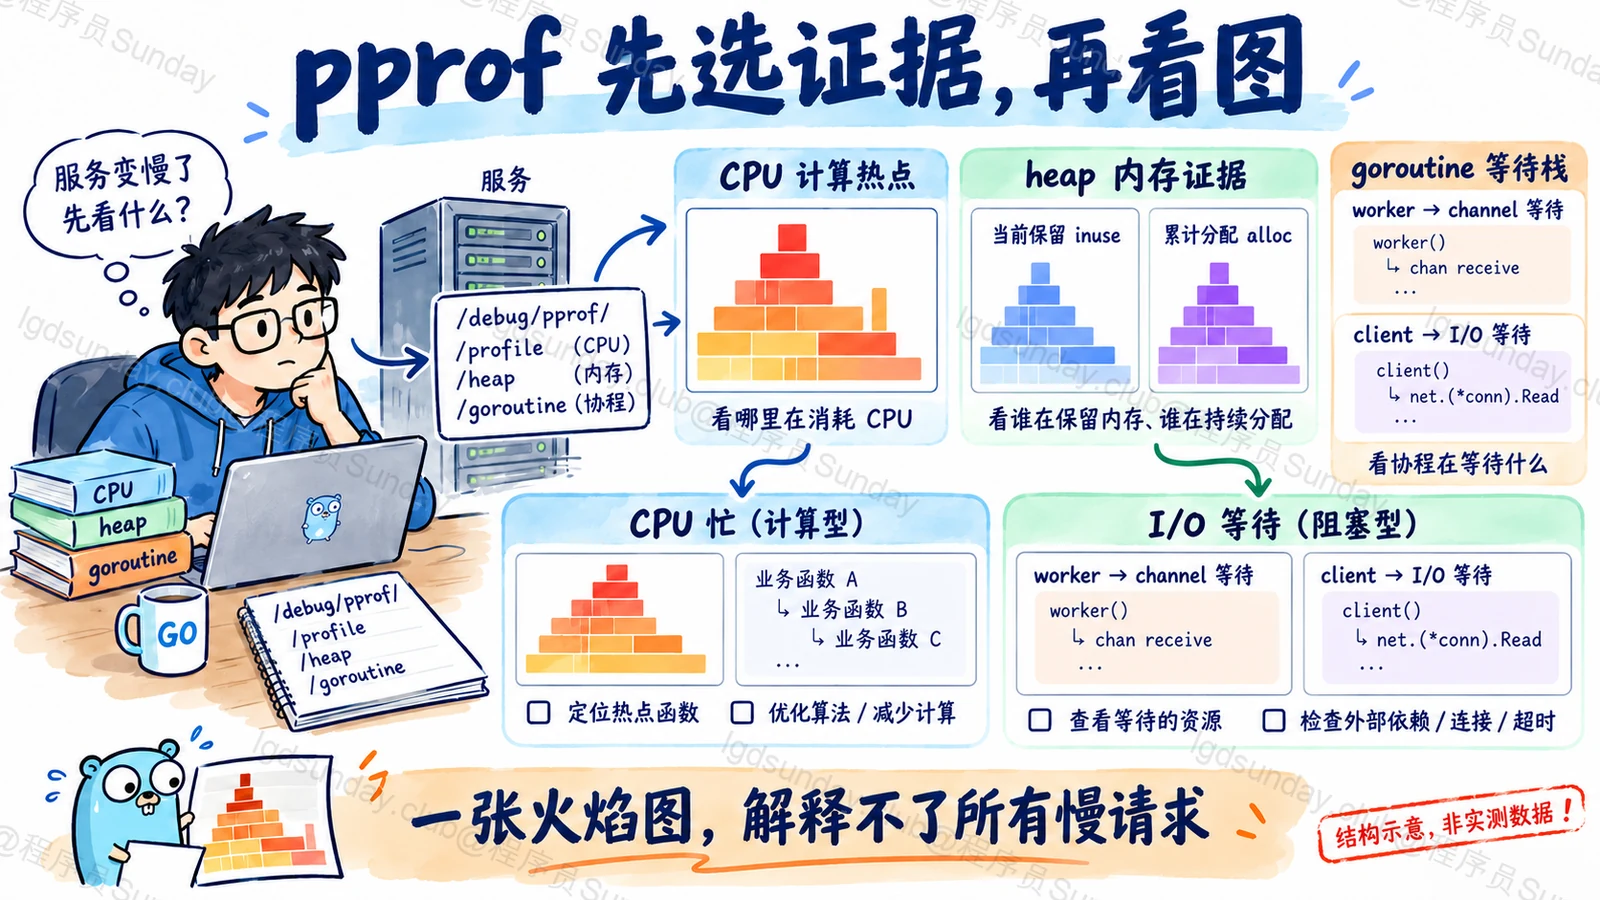
pprof 先选证据,再看图。CPU 采样、当前内存与阻塞栈描述的现象不同,不能用一张火焰图解释所有慢请求。
面试速答(60 秒版)
pprof 用来采集和分析 Go 程序的性能剖析数据。CPU profile 主要看采样期间代码消耗 CPU 的位置;heap profile 看采样的堆分配情况,通常要区分仍保留的 inuse 与累计分配的 alloc 指标;goroutine profile 则帮助查看 goroutine 当前停在哪些调用栈。
因此 CPU 高,优先看 CPU 样本;内存持续增长,比较多份 heap,区分保留和分配压力;goroutine 数量上涨或请求长时间等待,则结合 goroutine、block 或 mutex profile 找阻塞位置。
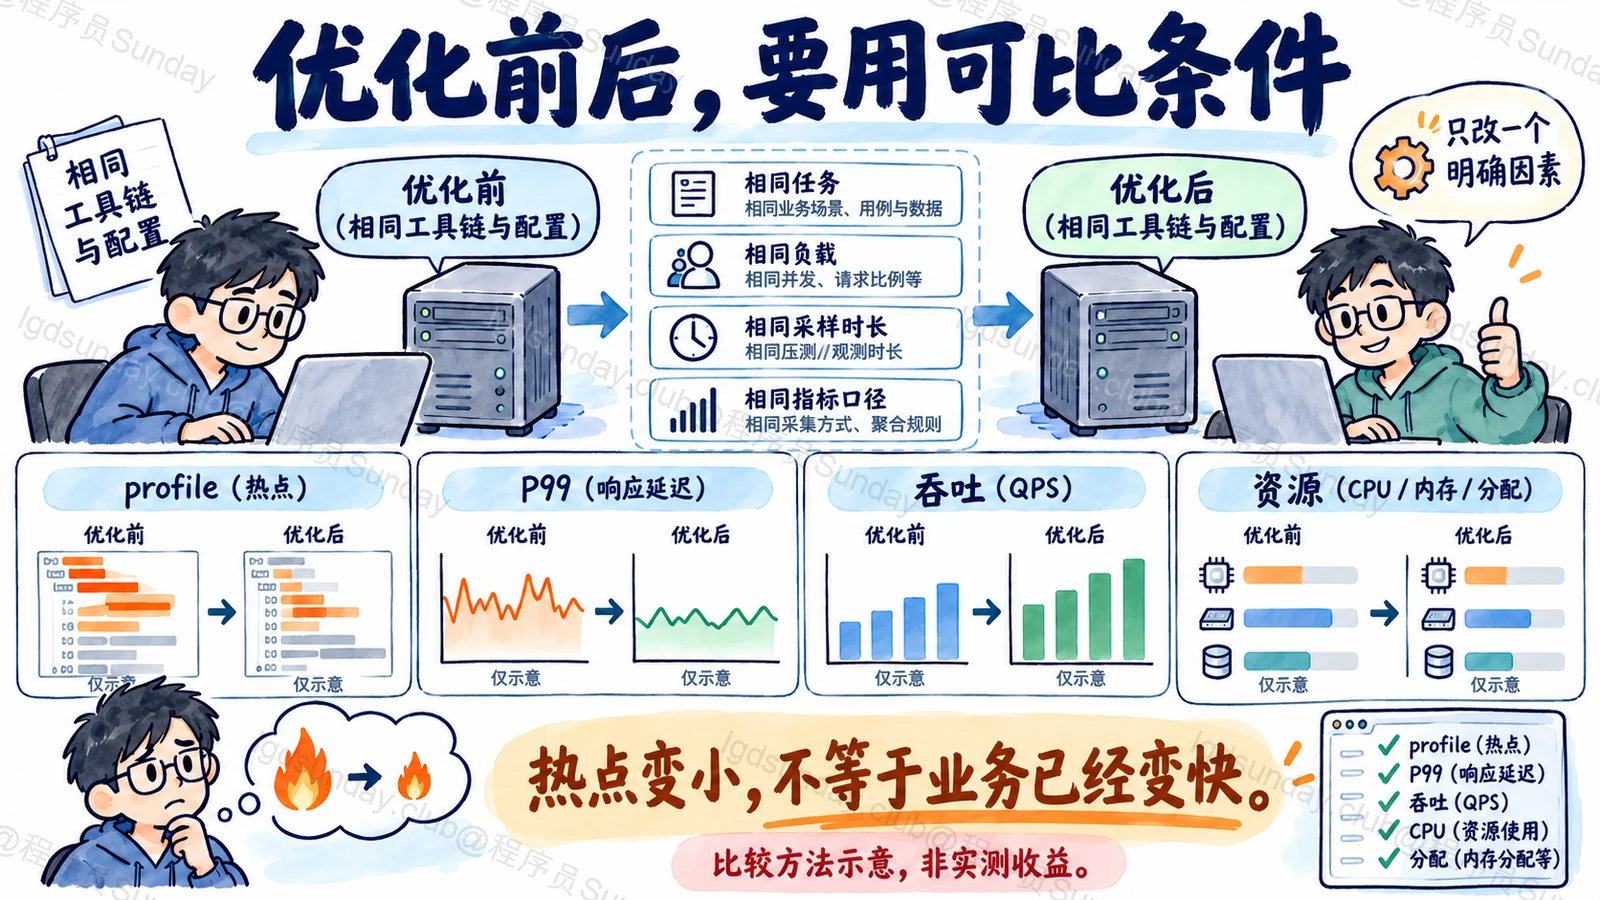
分析时还要看采样窗口、负载、构建版本和运行环境。一次采样看到热点,只能提供线索,修改后应在可比条件下复测延迟、吞吐和资源使用。
pprof 端点也不应直接暴露公网,里面可能包含程序结构和运行信息,需要单独限制访问。
知识点详解:服务慢,到底是忙着算,还是停着等?
同一个“慢”,先分成不同问题
假设一个 Go 接口响应变慢。它可能在大量计算 JSON,也可能在等连接池、锁或外部服务。这几种情况对用户都表现为等待,但 CPU 行为不一样。
CPU profile 通过一段时间内的采样,帮助定位活跃计算。某个函数占比高,表示它在这份 CPU 样本里占了较大份额,不等于它解释了同样比例的端到端请求时间。
如果大部分时间在网络等待,CPU profile 可能没有特别突出的热点。此时应结合请求 Trace、依赖延迟和等待栈继续查,而不是反复缩短一个本来就不占主要时间的小函数。Go 诊断文档区分了 profiling 和 tracing 的用途。
heap 要先选对计量口径
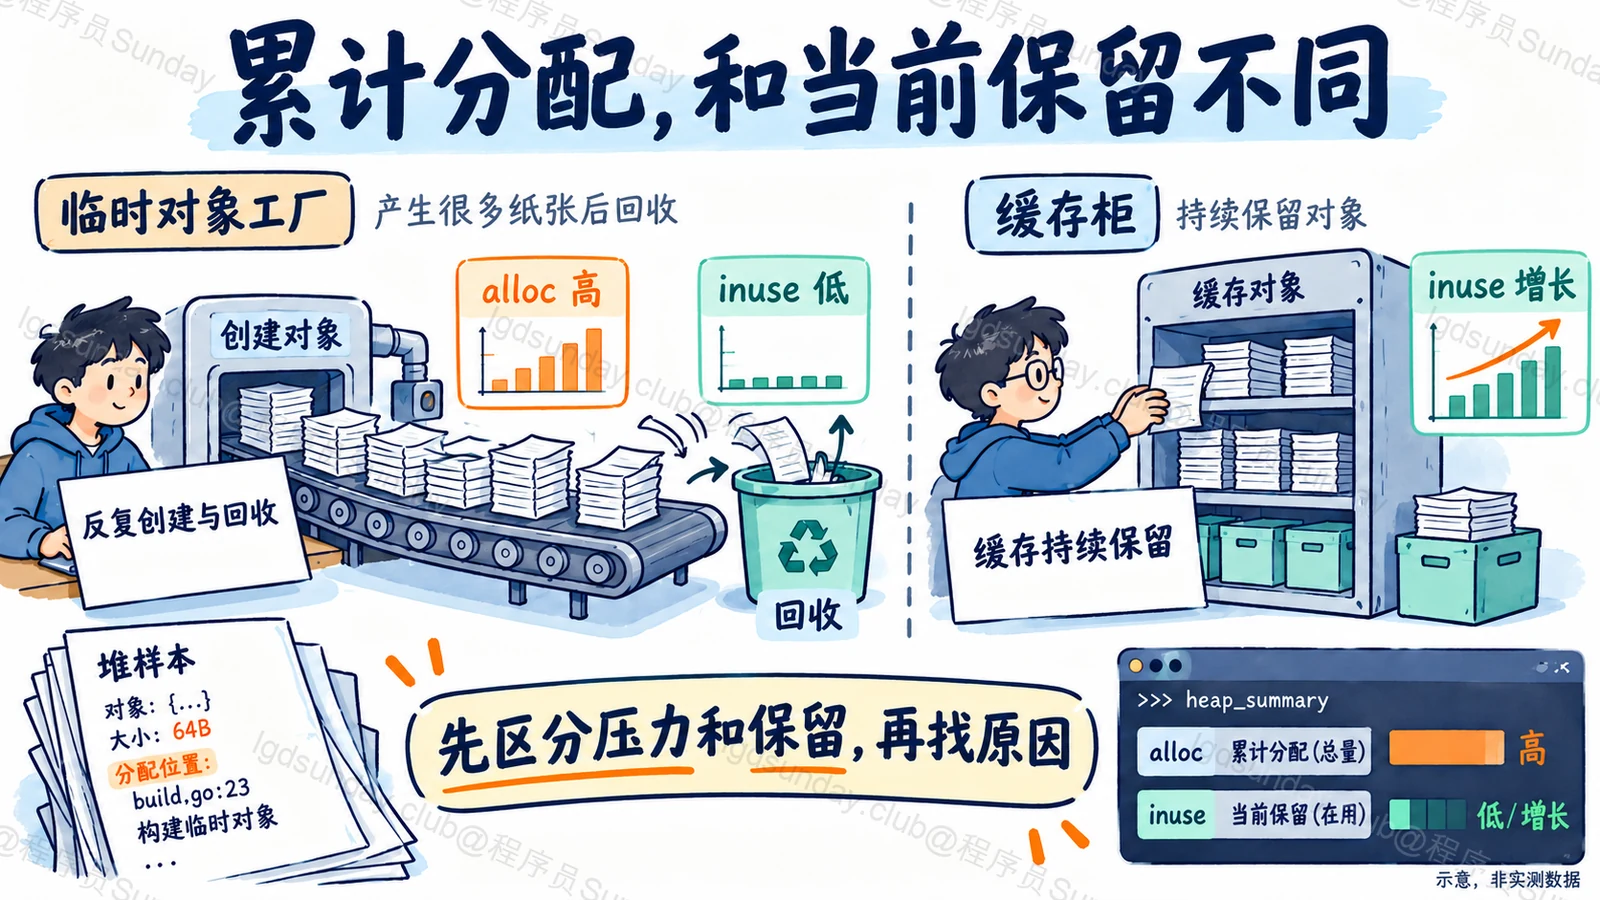
inuse_space 侧重采样中当前保留的字节,适合查哪些分配位置的对象仍然占着堆。alloc_space 侧重累计分配量,更适合看反复创建临时对象造成的分配压力。
因此某个函数 alloc 很大,但 inuse 不大,可能表示它分配了很多最终被回收的临时对象;inuse 持续增加,则还需要看缓存、引用保留或任务积压。二者都可能带来成本,但修复方法不同。
heap profile 通常按分配栈归因,不能仅凭分配栈就知道“到底是谁还保留着引用”。它也不是整个进程 RSS 的完整账单,线程栈、运行时和其他映射都可能影响进程内存。
runtime/pprof 文档说明了各类 profile 的语义和采样限制。
goroutine、block 和 mutex 又各看什么?
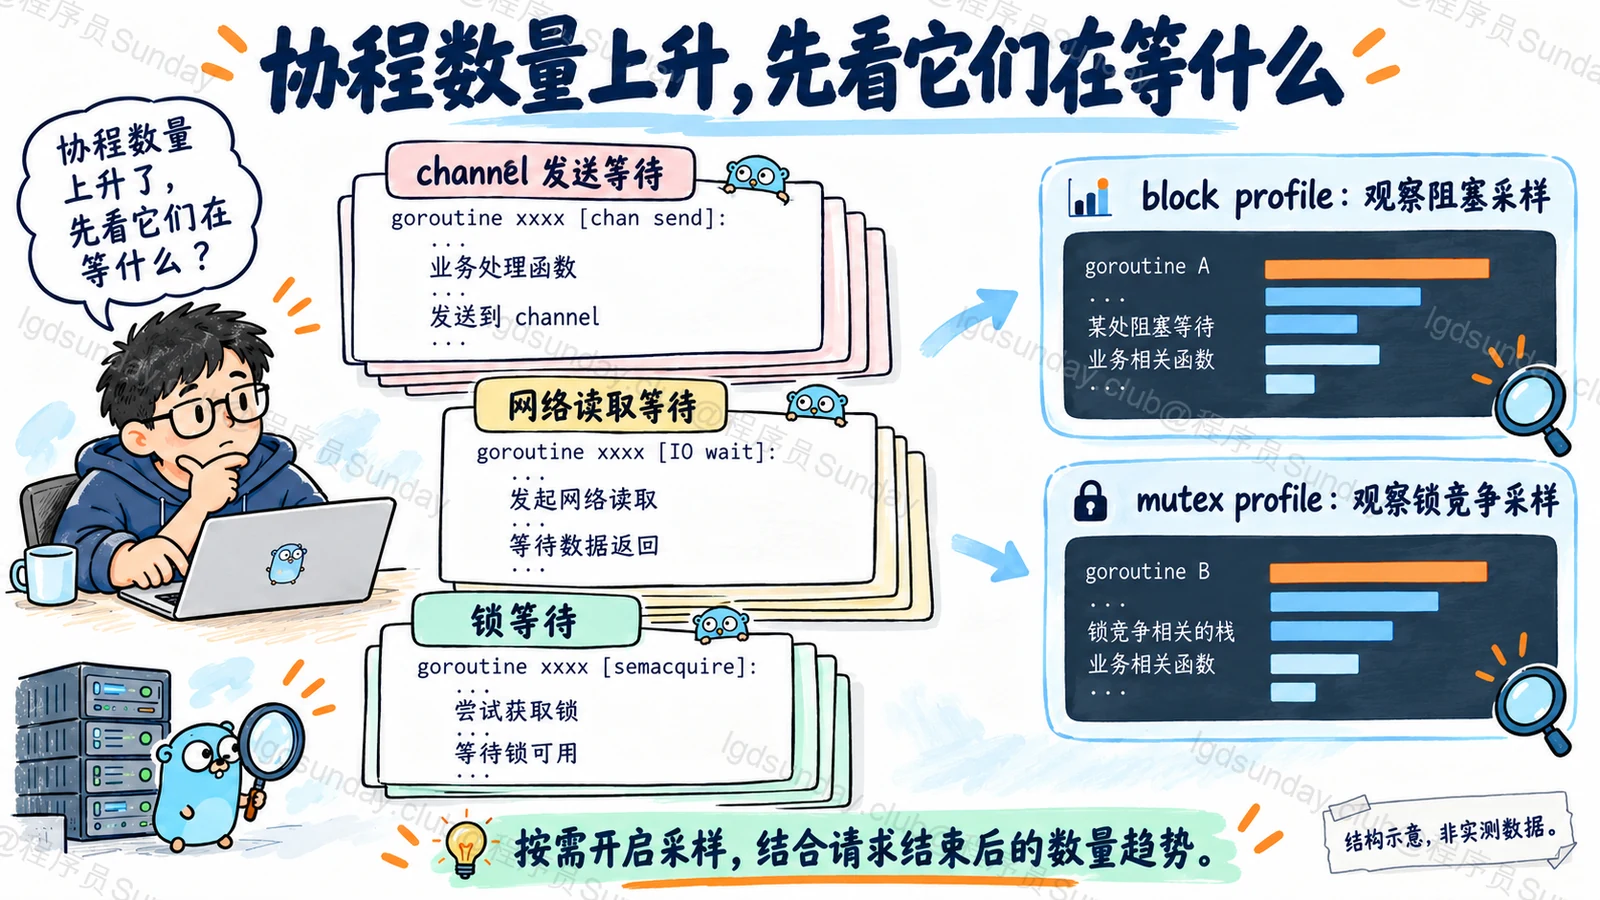
goroutine profile 是查看等待位置的重要入口。相同业务栈随请求次数不断累积,就值得追踪谁启动、谁负责退出。
block profile 关注阻塞在同步操作上的时间,mutex profile 关注锁竞争带来的等待,二者需要按配置启用相应采样。不要把“没有采到样本”直接解释为“没有锁竞争”,先检查采样是否开启、窗口是否覆盖了故障。
更细的调度、阻塞和事件顺序,可以继续使用 execution trace。工具之间应当互相补证,而不是只保留一张看起来最复杂的图。
采集和复测放在同一份记录里
假设已有仅允许本机访问的诊断服务,常用命令如下。这里演示 Go 工具命令,没有需要补齐的 TS/Python 实现。
go tool pprof 'http://127.0.0.1:6060/debug/pprof/profile?seconds=10'
go tool pprof -sample_index=inuse_space 'http://127.0.0.1:6060/debug/pprof/heap'
go tool pprof -sample_index=alloc_space 'http://127.0.0.1:6060/debug/pprof/allocs'
采集前记录程序版本、流量类型和时间窗口。定位后只改一个明确因素,再在相近条件下复测。不要把某次“看起来窄了”的火焰图,当成接口 P99 已经改善的证据。
诊断服务应绑定受控地址并经过必要访问限制,避免和业务路由一起无意开放。net/http/pprof 文档列出了 HTTP 采集入口。
面试官继续追问
火焰图最宽的函数一定最该优化吗?
还要看业务目标与总成本。有些工作本来就应该消耗 CPU,也可能属于采样窗口里其他请求。先确认它对应目标路径,再估算优化能否改变真正受影响的延迟或容量。
heap 采集时强制 GC 可以吗?
某些排查会在采集前触发 GC,以观察回收后仍保留的对象,但它会改变运行现场,也有成本。应把操作记录下来,不能拿触发条件不同的两份结果直接作同口径比较。
怎么证明不是测试流量带来的假热点?
保留采样窗口和请求分布,尽量覆盖实际问题。修改前后同时比较业务指标和 profile,并说明未覆盖的负载范围。没有真实生产样本时,就明确这是本地实验,不延伸成线上结论。
面试速记卡
- CPU:看活跃计算,不等同端到端等待时间。
- heap:先分当前保留与累计分配,再分析原因。
- goroutine:看当前栈;block、mutex:按采样配置查等待与竞争。
- 验证:相同口径、可比负载,修改后复测业务指标。
- 访问:诊断端点限制开放范围,不直接暴露公网。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
百度 · 后端(搜索) · 日常实习
CPU 利用率报警时怎样排查,是否用过 pprof?(题意整理)
百度搜索后端二面 9.2 ↗
标题记录 9 月 2 日二面;页面显示 09-11 编辑,未明确年份安克创新 · Go开发(原帖未明确细分岗位) · 实习
怎样用 pprof 排查内存泄漏和 CPU 飙高?(题意整理)
安克创新golang面经 ↗
原帖编辑于 2025-07-16云览科技 · Go开发(原帖未明确细分岗位) · 社招
线上 goroutine 从 2000 增长到 10 万,怎样用 pprof 确认泄漏位置?(题意整理)
云览科技一面 ↗
正文明确面试于 2026-09-09;页面显示 09-10 发布,未明确发布年份腾讯 · 后台开发(IEG 天美) · 暑期实习(原帖说明)
怎样排查内存泄漏问题,pprof 怎样使用?(题意整理)
腾讯IEG 天美 后台开发面经 ↗
原帖发布于 2024-03-02腾讯 · 后端开发 · 社招
怎样用 pprof 定位问题并进行调优?(题意整理)
腾讯、字节跳动、b站后端面经 ↗
原帖编辑于 2020-04-20