
Go 的 byte、rune 和 string 有什么区别?中文字符串长度怎么算?
以下是一段用于讲解的模拟面试对话。
🧑💻 面试官: len("你好") 在 Go 里是多少?
🙋♂️ 我: 是 6,因为 UTF-8 编码下每个汉字占三个字节。
🧑💻 面试官: 那转成 []rune 以后,长度就是用户看到的字符数了吗?
🙋♂️ 我: 应该是,它能处理中文。
🧑💻 面试官: 一个家庭 emoji 可能由多个码点组成;一个字母也可能带组合音标。此时你到底在数什么?
字节、Unicode 码点和用户眼中的一个字符,是三种不同的计数单位。先明确需求,再选择长度算法。
面试速答(60 秒版)
Go 的 byte 是 uint8 的别名,通常用来表示一个字节;rune 是 int32 的别名,通常用来表示一个 Unicode 码点。string 保存不可变的字节序列,本身不保证内容一定是合法 UTF-8。
因此 len(s) 统计字节数,s[i] 取到的也是字节。对合法 UTF-8 文本,range 会按码点解码,utf8.RuneCountInString 可以统计码点数。
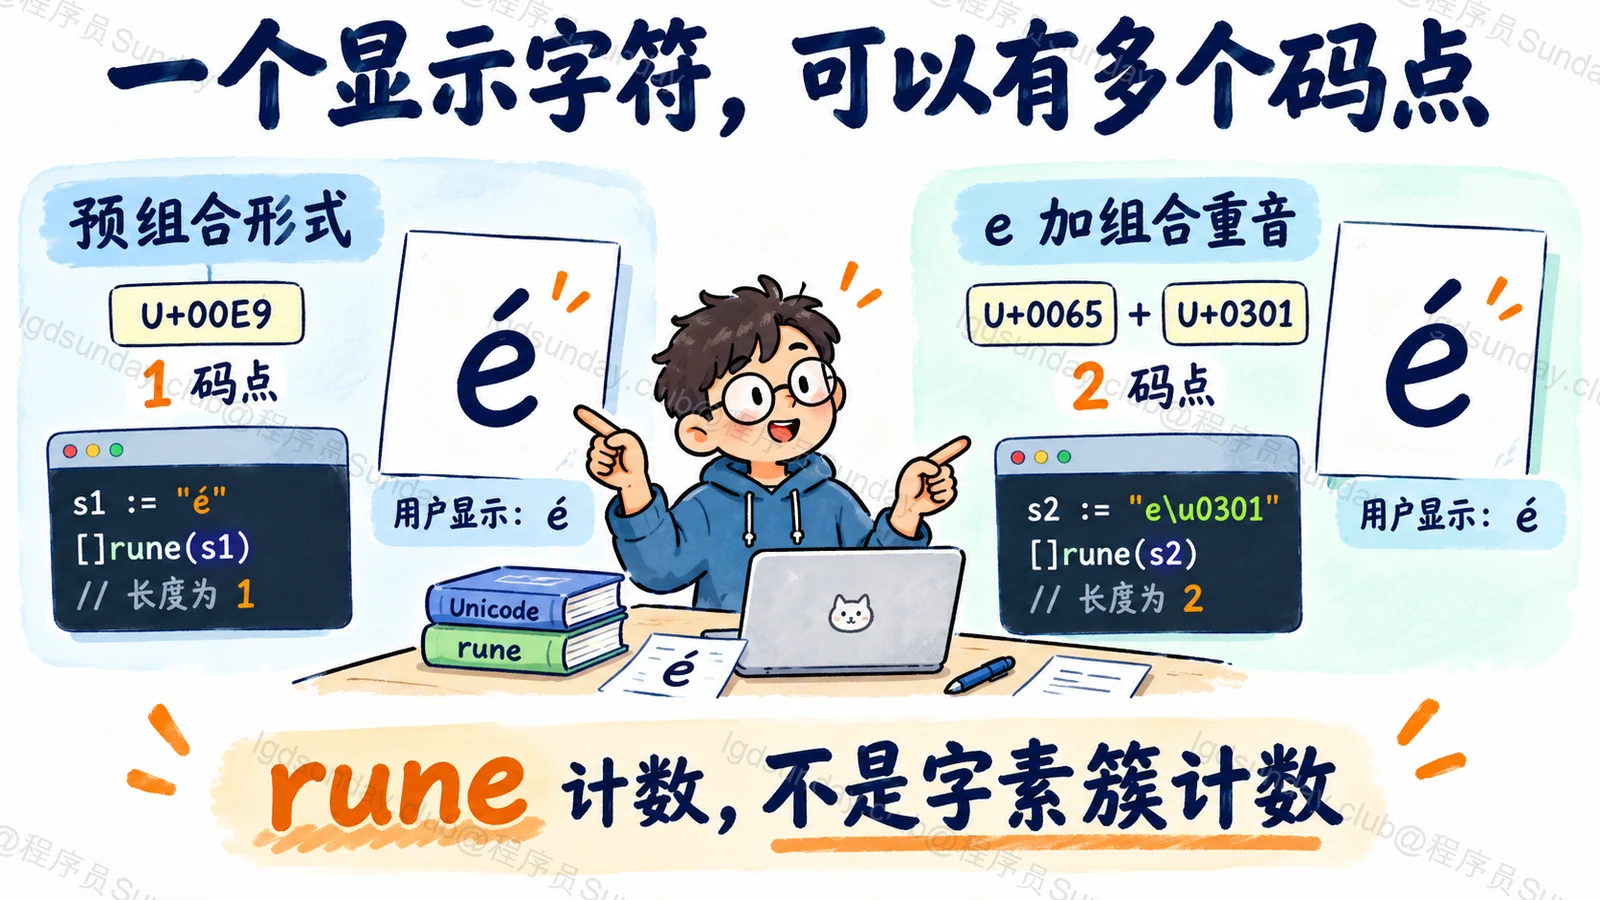
但一个用户看到的字符,可能由多个码点组成,比如组合音标和部分 emoji。需要做界面字符计数或按完整字符截断时,应按 Unicode 字素簇规则处理,不能把 rune 数直接当成显示字符数。
工程上,网络和文件大小看字节,处理码点看 rune;用户输入长度限制要先说清产品采用的计数规则。
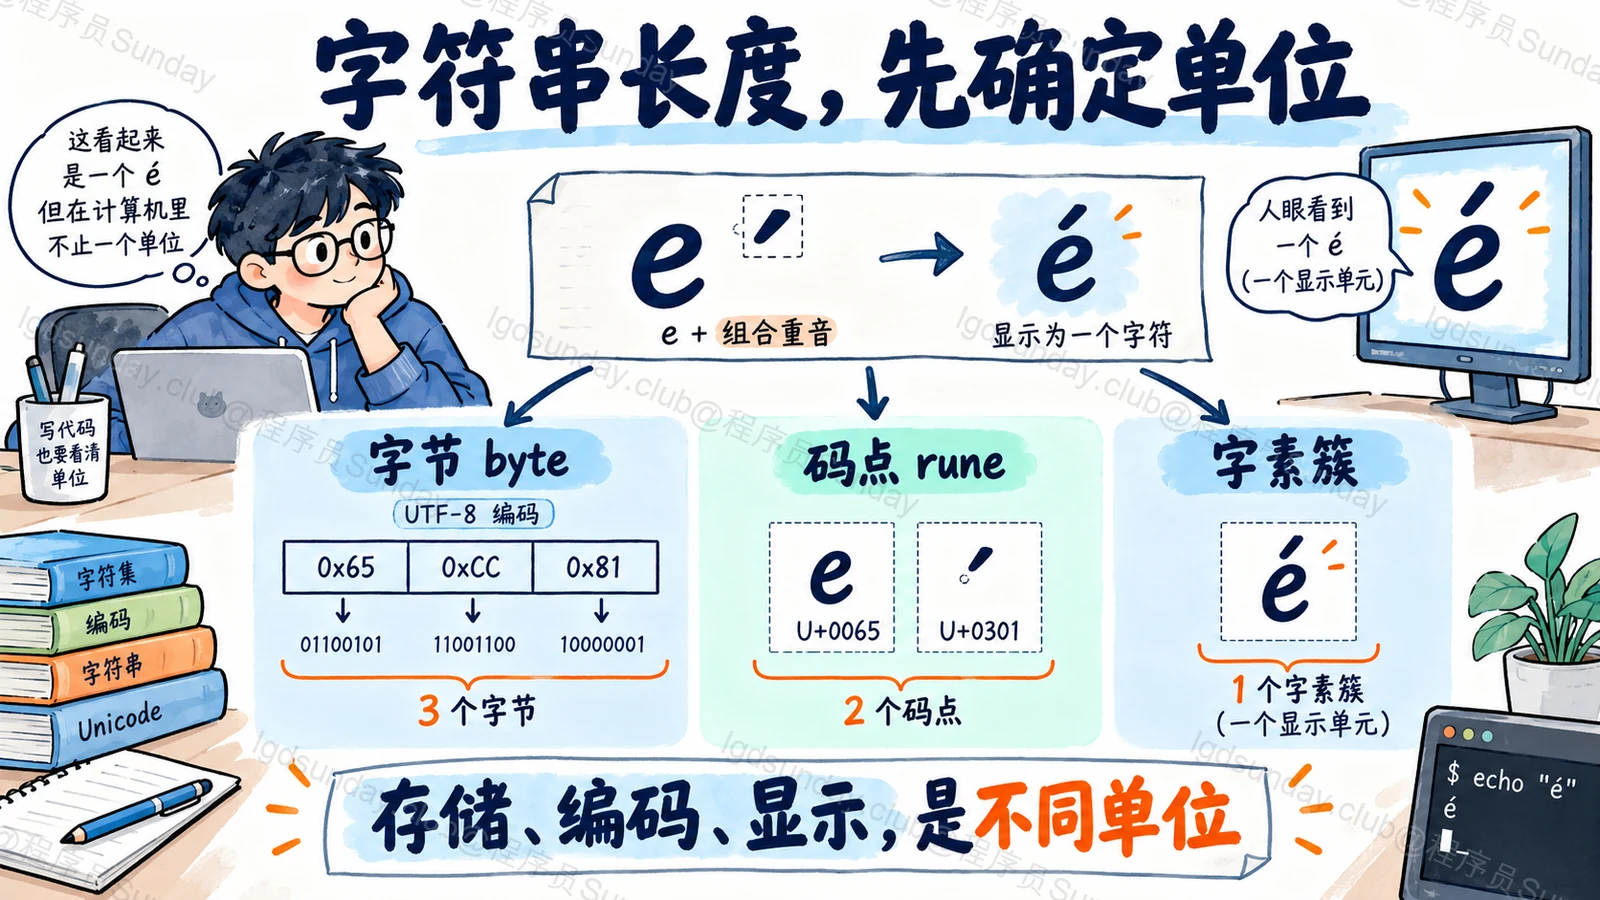
知识点详解:为什么“两个字”会有三个不同的长度?
先把字节和码点放在同一行看
package main

import (
    "fmt"
    "unicode/utf8"
)

func main() {
    s := "你好"
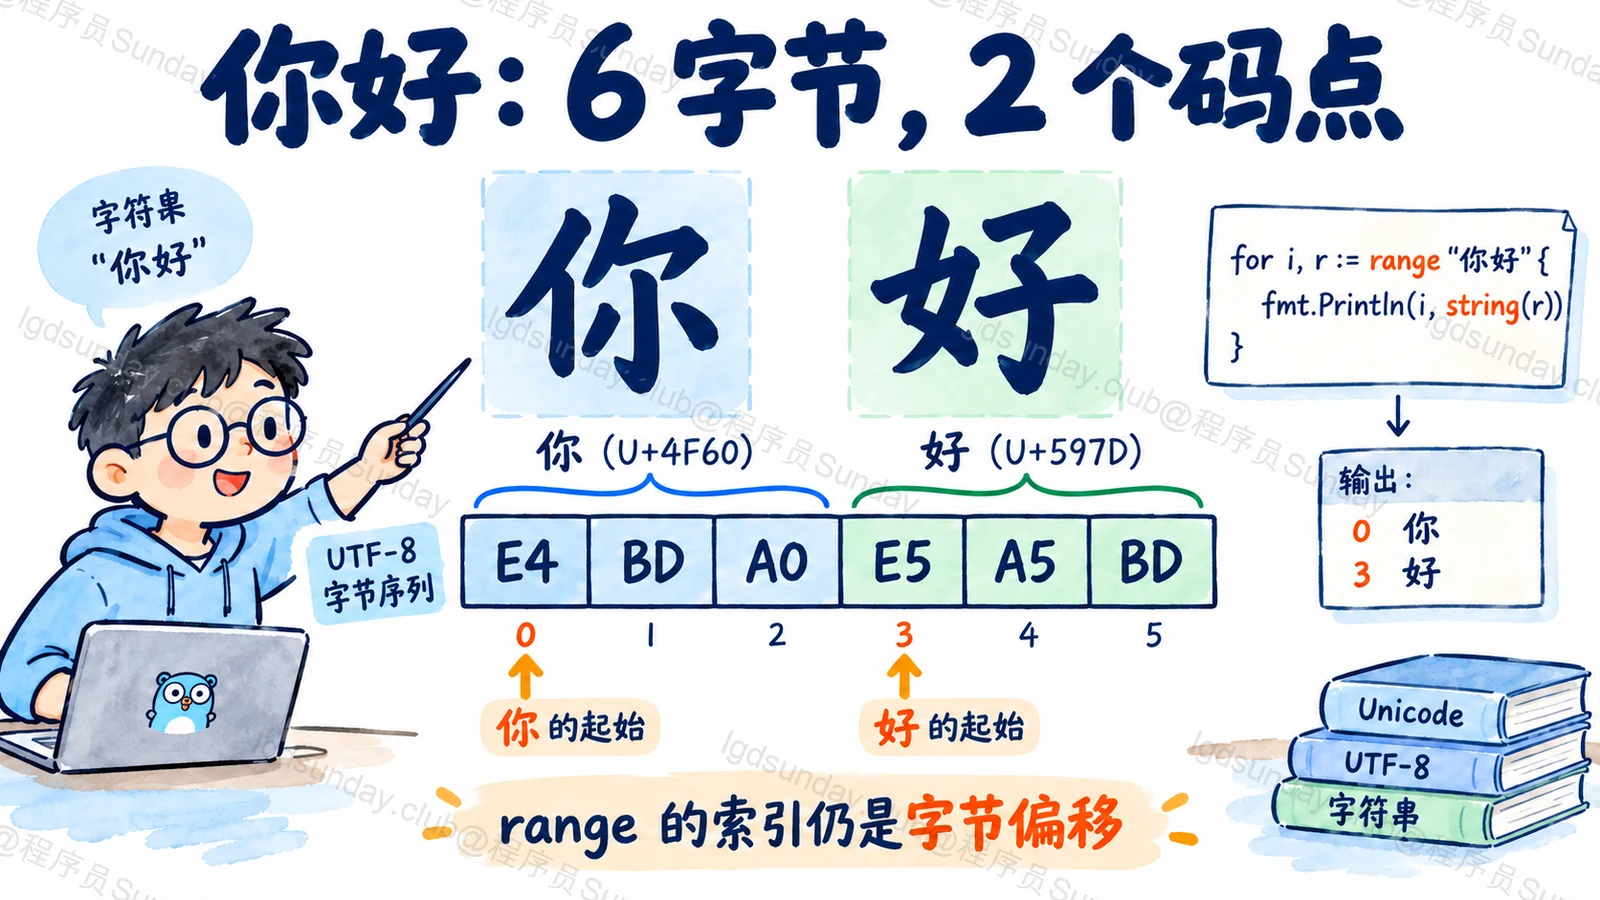
    fmt.Println(len(s), utf8.RuneCountInString(s)) // 6 2
    for i, r := range s { fmt.Printf("%d:%U ", i, r) }
    fmt.Println() // 0:U+4F60 3:U+597D
    fmt.Println(len("é"), utf8.RuneCountInString("é"))
    fmt.Println(len("e\u0301"), utf8.RuneCountInString("e\u0301"))
}
range 返回的 i 仍然是字节偏移,所以第二个汉字从 3 开始。r 才是解码后的码点。这两个变量描述的单位不同,并没有矛盾。
最后两行更有意思。预组合的 é 是两个 UTF-8 字节、一个码点;e 加组合重音是三个字节、两个码点。它们在界面上可能看起来一样,但字节表示和码点数都不同。
官方字符串说明和unicode/utf8 文档把字节存储与解码操作分开描述。
截字符串前,先问不能截坏哪一层
如果直接写 s[:1],得到的可能是一个汉字的第一个字节,已经不是完整 UTF-8 文本。按 []rune 截取,可以避免把一个合法码点从中间切开,但依然可能拆开组合音标或者 emoji 序列。
因此,“支持中文截断”这个需求还不够具体。服务器日志只要求输出合法 UTF-8,和输入框要求用户看见完整字符,所需方案可能不同。
需要完整的显示字符边界时,要选择符合 Unicode 字素簇分段规则的实现。Go 标准库的 rune 计数不是字素簇计数器,不能只换一个函数名字就承诺解决。
string 不可变,也不代表内容一定有效
Go string 可以包含任意字节。比如从外部拿到一段损坏的 UTF-8,它仍然可以放进 string。需要保证编码有效时,可以用 utf8.ValidString 检查。
range 遇到无效编码时会产生 RuneError,并向前处理无效字节。这个行为方便遍历,但不是输入已经通过合法性验证的证明。
同样,[]byte(s) 和 []rune(s) 分别是在按字节或按码点组织数据。只需要查一个前缀时,不必为了“支持 Unicode”就无条件创建整份 rune 切片;额外分配也应当和需要完成的操作相对应。
本题是 Go 字符串的具体语义,只使用 Go 代码,不把 TS/Python 各自的字符串索引规则翻译成同一种行为。
面试官继续追问
用户名最多 20 个字符,应该怎么限制?
先与产品确认是 20 字节、20 码点还是 20 个字素簇。还要确认是否先做 Unicode 规范化,以及规范化会不会改变身份比较。把这个规则写进服务端校验,前端提示也采用同一套口径。
string 转 byte 切片一定会复制吗?
语义上得到的是可修改的字节切片,后续修改不能影响原字符串。具体编译器能否在特定只读场景优化分配,要看实现和测量;不要把 unsafe 零拷贝写成普通业务代码的默认方案。
测试只放几个汉字够吗?
不够。至少加 ASCII、汉字、预组合字符、组合音标、emoji 序列和无效 UTF-8。长度测试同时记录单位,避免一个测试用例通过,却不知道自己验证的到底是什么。
面试速记卡
- byte:一个字节;rune:通常表示一个 Unicode 码点。
- string:不可变字节序列,不自动保证合法 UTF-8。
- len 与索引:按字节;range 的值按码点解码,索引仍是字节偏移。
- 用户字符:可能包含多个码点,需要字素簇规则。
- 截断与计数:先确定单位,再选择算法与测试数据。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
百度 · 后端(搜索) · 日常实习
用 Go 按 offset 和 length 截取 UTF-8 子串,不能隐式转换或深拷贝,怎样实现?(题意整理)
百度搜索后端二面 9.2 ↗
标题记录 9 月 2 日二面;页面显示 09-11 编辑,未明确年份