
正则表达式为什么会卡死页面?贪婪匹配、回溯和 ReDoS 应该怎么理解?
下面是用于讲题的模拟面试对话。
🧑💻 面试官:一个正则只匹配字母,为什么输入变长以后,页面会突然卡住?
🙋♂️ 我:可能是回溯路径很多,尤其快匹配完才失败的时候。
🧑💻 面试官:那把贪婪量词改成懒惰量词,就能保证很快吗?
🙋♂️ 我:它主要改变尝试顺序,未必消除大量候选路径。
🧑💻 面试官:用 setTimeout 包着匹配,超过一秒就取消,能打断主线程正在执行的正则吗?
正则的危险不只在输入长度,也在同一段输入能被分成多少种匹配路径。失败位置和执行线程,会把这份开销放大。
面试速答(60 秒版)
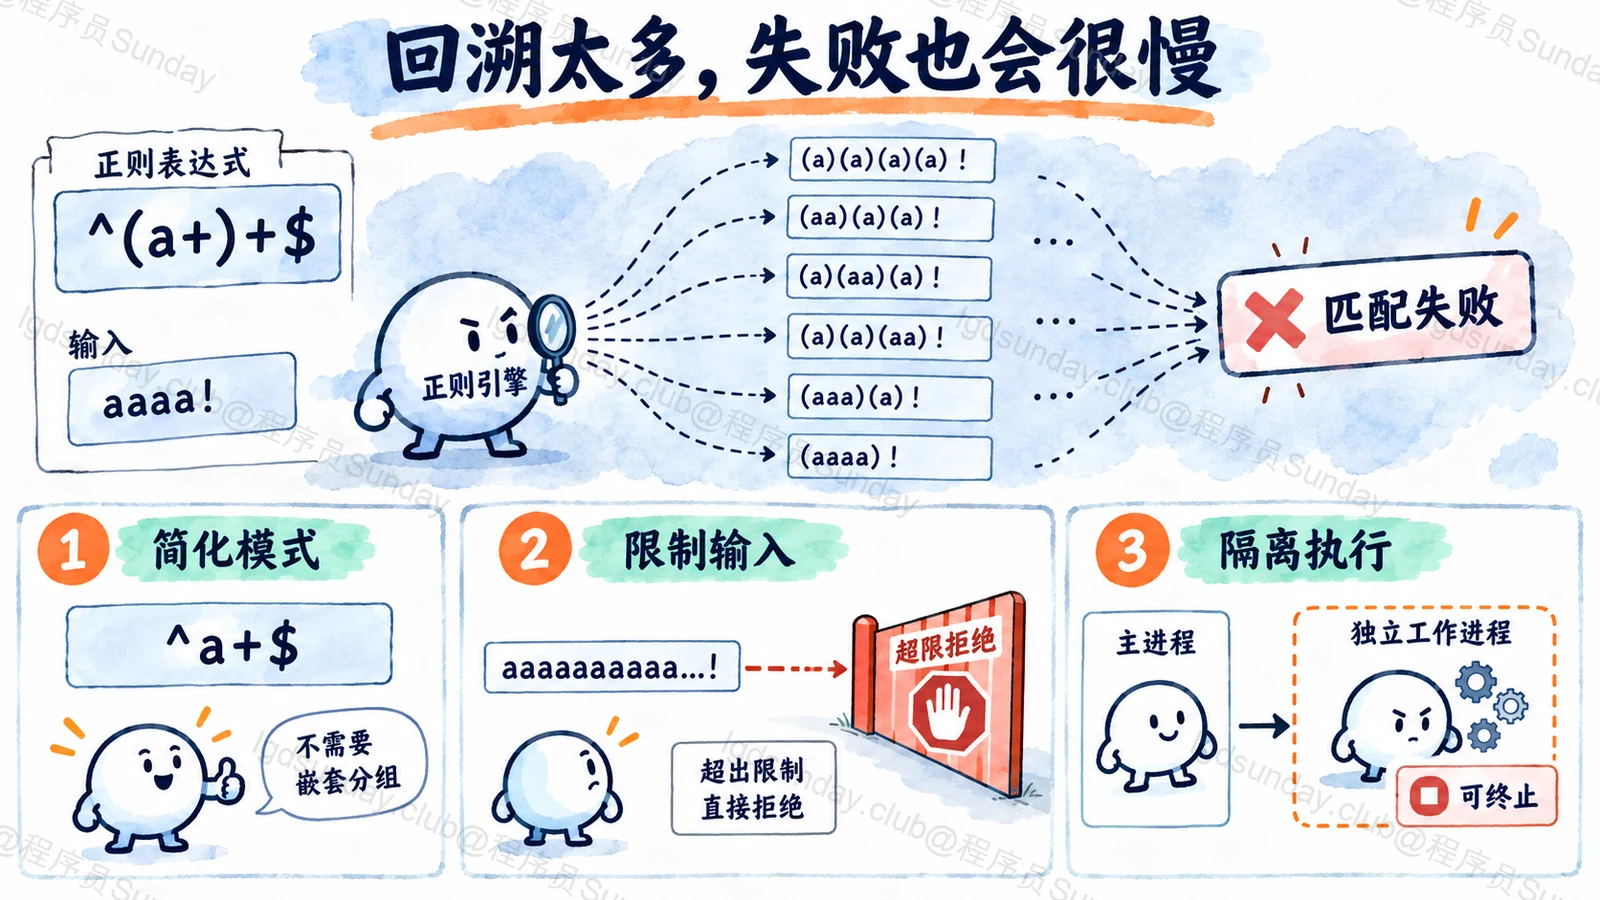
很多正则引擎会在匹配失败时回到之前的选择,换一种方式继续尝试。某些嵌套重复或含糊的分支,可能让同一段输入产生大量候选,最终形成很高的时间开销。
贪婪和懒惰量词主要控制先尝试更多还是更少,不保证复杂度降低。如果后面始终失败,两种顺序都可能探索很多路径。
当不可信输入能触发这种高开销,消耗服务线程或卡住页面时,就可能形成 ReDoS。防护要限制输入规模、简化含糊结构,并按需要选择有明确复杂度保证的匹配方案。
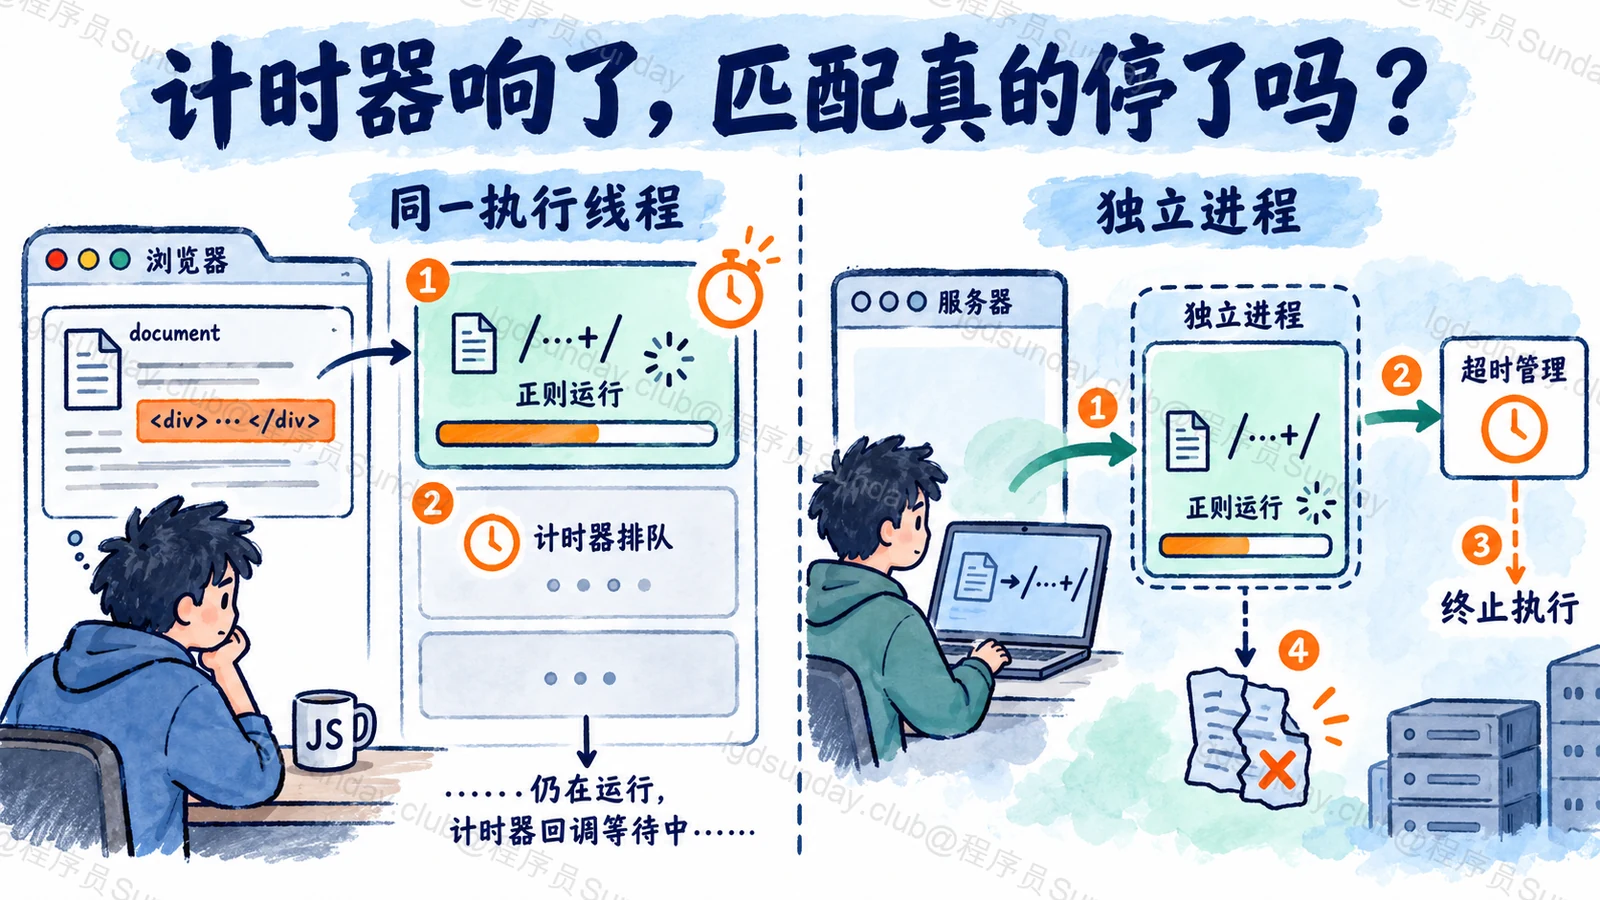
浏览器主线程同步运行的正则,也不能靠同一线程的定时器直接中断。需要隔离和超时控制时,应确认执行环境真的支持终止;不能只是在外面多包一个 Promise。
知识点详解:失败以后,引擎还会尝试什么?
从一个很小的模式看分组方式
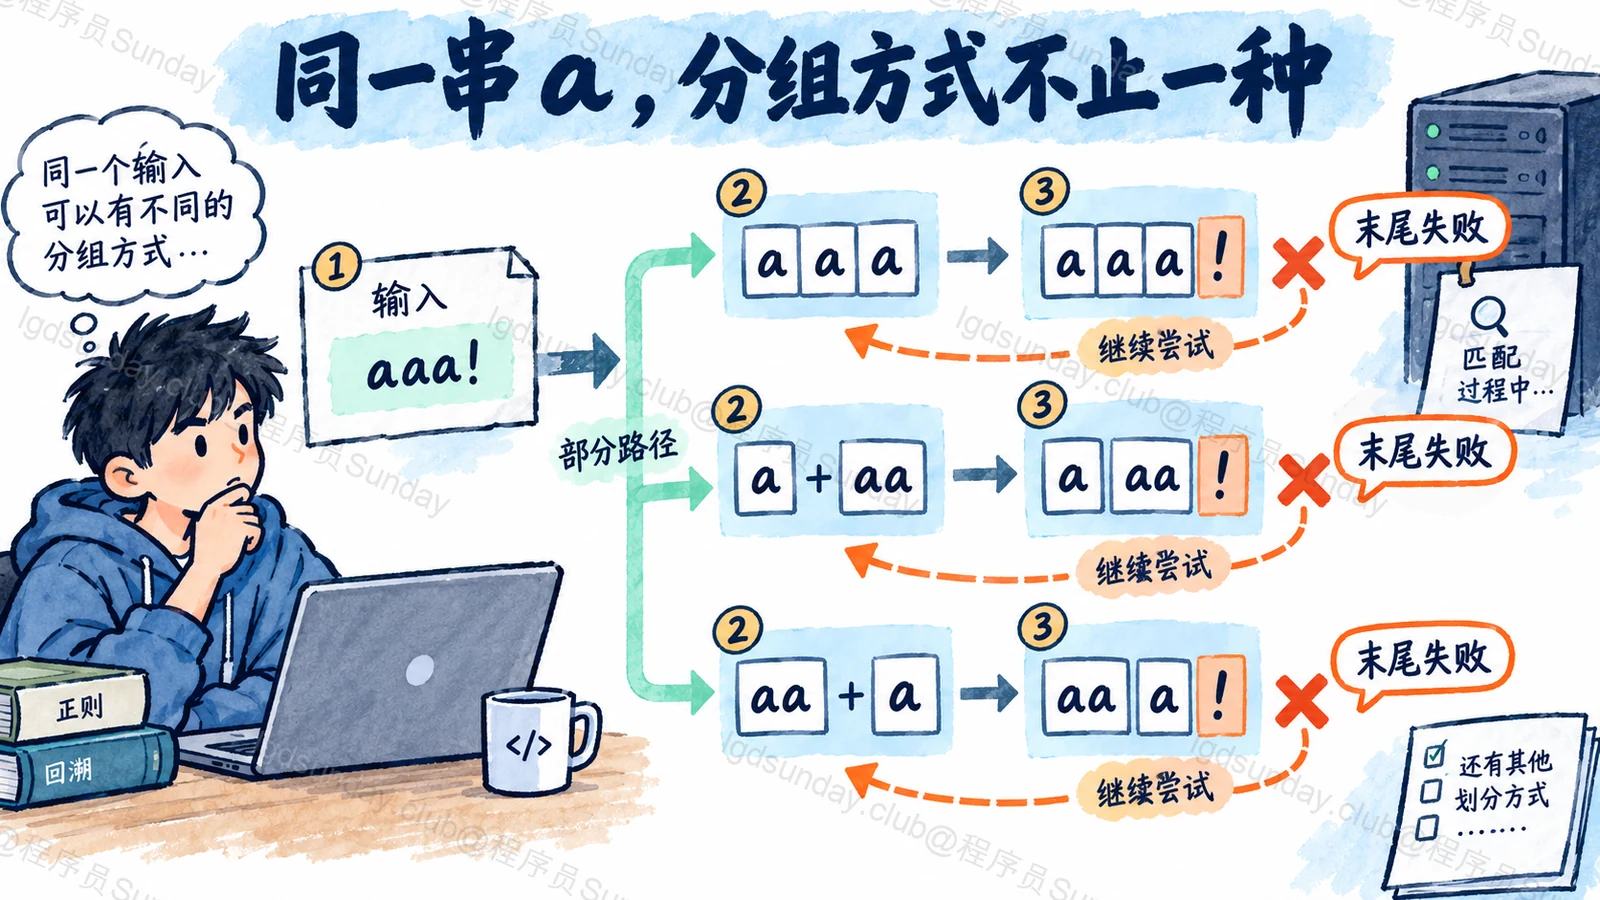
例如 ^(a+)+$,内部和外部都有重复。对于连续的 a,它可以先把很多字符归给里面的一次重复,也可以把它们分成多段,再让外层重复接起来。
如果输入最后多了一个不允许的字符,前面的匹配可能已经走了很远,随后需要尝试其他分配方式。输入越长,可探索的分组越多。这里仅用很短的字符串解释,不需要真的运行长输入让电脑卡住。OWASP ReDoS介绍了这类风险模式。
为什么改成懒惰匹配不够?
贪婪会先多拿一些字符,失败后往回退;懒惰先少拿,必要时再增加。它们改变先走哪条路,却不一定减少总共存在的路。
如果实际目标只是“整个字符串至少一个 a,且没有其他字符”,一次简单匹配再加上完整输入检查就够了,没有必要让两个重复层次互相分配相同字符。这里还要留意引擎差异,不能把结尾锚点和严格的完整匹配直接当成同一回事。
不同引擎还有优化和不同算法,所以不要把一个测试机上的耗时比例写成所有环境的固定规律。判断应同时说明模式、输入、引擎版本和是否允许回溯。
先消除不需要的含糊结构
下面只检查短输入。两种语言采用各自内置正则,示例不包含耗时攻击载荷,也不声称它们的全部匹配细节相同。
const isOnlyA = (text: string) =>
  text.length > 0 && text.length <= 100 && !/[^a]/.test(text);

console.log(isOnlyA("aaaa"));   // true
console.log(isOnlyA("aaaa!"));  // false
console.log(isOnlyA(""));       // false
import re
def is_only_a(text: str) -> bool:
return len(text) <= 100 and re.fullmatch(r"a+", text) is not None
print(is_only_a("aaaa")) # True
print(is_only_a("aaaa!")) # False
print(is_only_a("")) # FalseTypeScript 这段先检查非空和长度,再排除任何非 a 字符;Python 使用 fullmatch 检查完整输入。这样,末尾带换行的字符串也不会被误判为合法。两种写法已经用包含换行及长度边界的短用例分别检查过。
长度上限只是这个演示的输入契约,不是通用安全阈值。真实字段的限制应由产品和处理成本决定。复杂结构如 URL、HTML 或编程语言片段,也要考虑直接使用合适的解析器。
超时要能够真正停止执行
如果同步匹配卡住了页面主线程,同一线程上的 setTimeout 回调也要等待执行机会。把匹配结果与一个超时 Promise 做 race,不能使已经占住线程的正则自动退出。
可以将高风险匹配放到可终止的 Worker 或隔离进程,并设置边界;但进程创建、数据传递和资源上限也要一起考虑。某些不回溯引擎提供更明确的复杂度保证,语法支持却可能不同,不能直接替换后不测结果。
验证时使用有界的小规模输入,比较正常匹配与接近结尾失败的输入。把测试放在有超时隔离的环境中,逐步增加范围,并保留语义一致性用例。不能为了证明风险在真实页面或生产接口上跑无界实验。
面试官继续追问
所有带 + 的正则都会 ReDoS 吗?
不会。需要看模式是否产生大量含糊选择、引擎怎样执行,以及输入是否受控。一个简单量词不能单独证明存在高复杂度风险。
限制长度以后,正则就一定安全吗?
它能限制单次最坏输入的规模,但可接受上限取决于模式和资源预算。还要考虑调用频率与并发,不能只设置一个很大的上限就结束检查。
Python 的标准 re 能直接设置匹配超时吗?
标准 re 的常用匹配 API 没有一个通用的 timeout 参数。需要超时控制时,应明确采用哪个库或进程隔离方案,不把其他正则库的参数搬过来。
面试速记卡
- 回溯在失败后探索其他选择,含糊重复可能产生大量路径。
- 贪婪与懒惰改变尝试顺序,不自动保证低复杂度。
- 优先简化模式、限制输入,再检查适合的解析或匹配方案。
- 主线程同步匹配不能靠同线程定时器直接打断。
- 在隔离、有界的测试中验证语义和耗时,不运行无界实验。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →