
大模型本地部署需要多少显存?参数量、精度和并发数怎么估算?
以下对话为教学模拟,不是真实面经。
🧑💻 面试官:一个 8B 模型,用 16GB 显存能运行吗?
🙋♂️ 我:FP16 参数大约占 16GB,应该差不多。
🧑💻 面试官:这算进上下文了吗?同时处理八个请求呢?
🙋♂️ 我:还要计算 KV Cache 和运行开销。
🧑💻 面试官:那“单个短请求能跑”和“服务能承受并发”,是不是同一个结论?
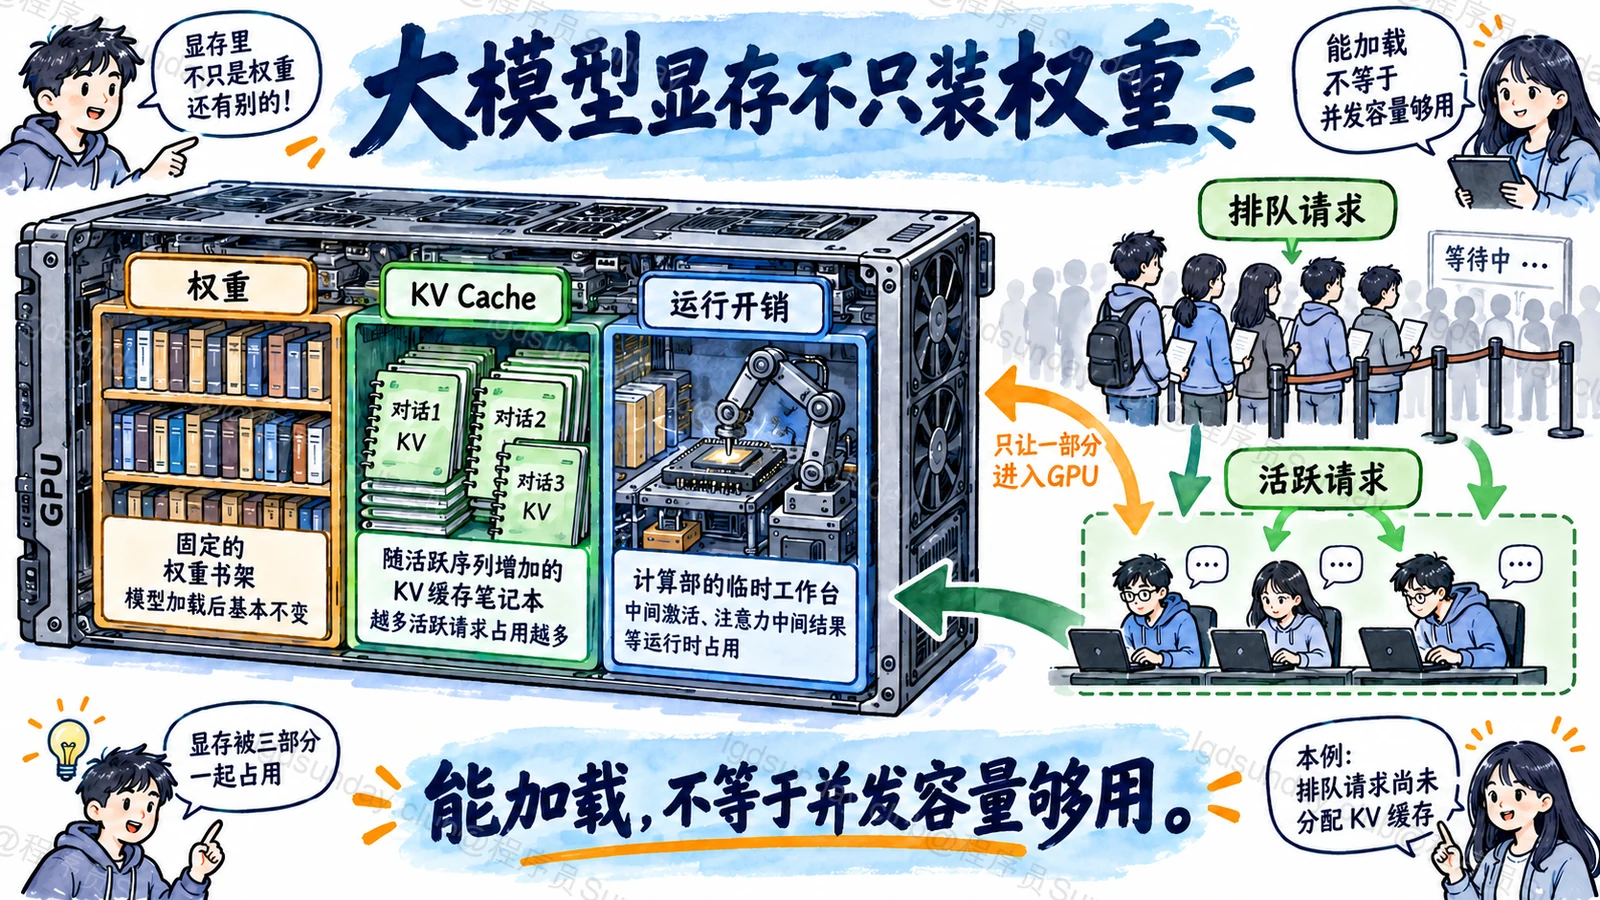
参数能放进去,只是第一步。服务需要的是:权重、活跃请求的缓存和运行峰值都放得下。
面试速答(60 秒版)
估算大模型推理显存时,我会分成权重、KV Cache 和运行开销三部分。
权重可以先用参数量乘以每个参数的存储字节数。例如 8B 参数采用 FP16,理想权重约为 16GB,但这还不是运行总显存。
KV Cache 会随着当前活跃请求数和保存的 Token 数增加,也与模型层数、KV 头数和缓存精度有关。上下文越长、同时生成的请求越多,缓存占用通常越大。
量化主要减少对应张量的存储,不代表全部显存都按同样比例下降。最终还需要按真实模型、推理引擎、上下文和并发配置测峰值,并留出运行余量。能加载模型,不能直接证明服务容量够用。
知识点详解:从权重大小,算到实际请求容量
第一笔是权重,但单位要说清楚
8B 在这里按 80 亿参数估算。FP16 每个参数理想占 2 字节,那么权重大小约为:
8,000,000,000 × 2 = 16,000,000,000 字节
≈ 16 GB,或 14.9 GiB
GB 按十进制计算,GiB 按 1024 的幂计算;显示单位不同,数字会不同。还要注意,实际模型不一定所有张量都采用同一种精度,加载器也可能保留额外信息。
阿里云的显存估算说明可以作为容量估算入口,但具体部署还要回到实际模型和引擎。这里讨论推理,不把训练所需的梯度、优化器状态混入同一个公式。
第二笔是 KV Cache,要按模型结构算
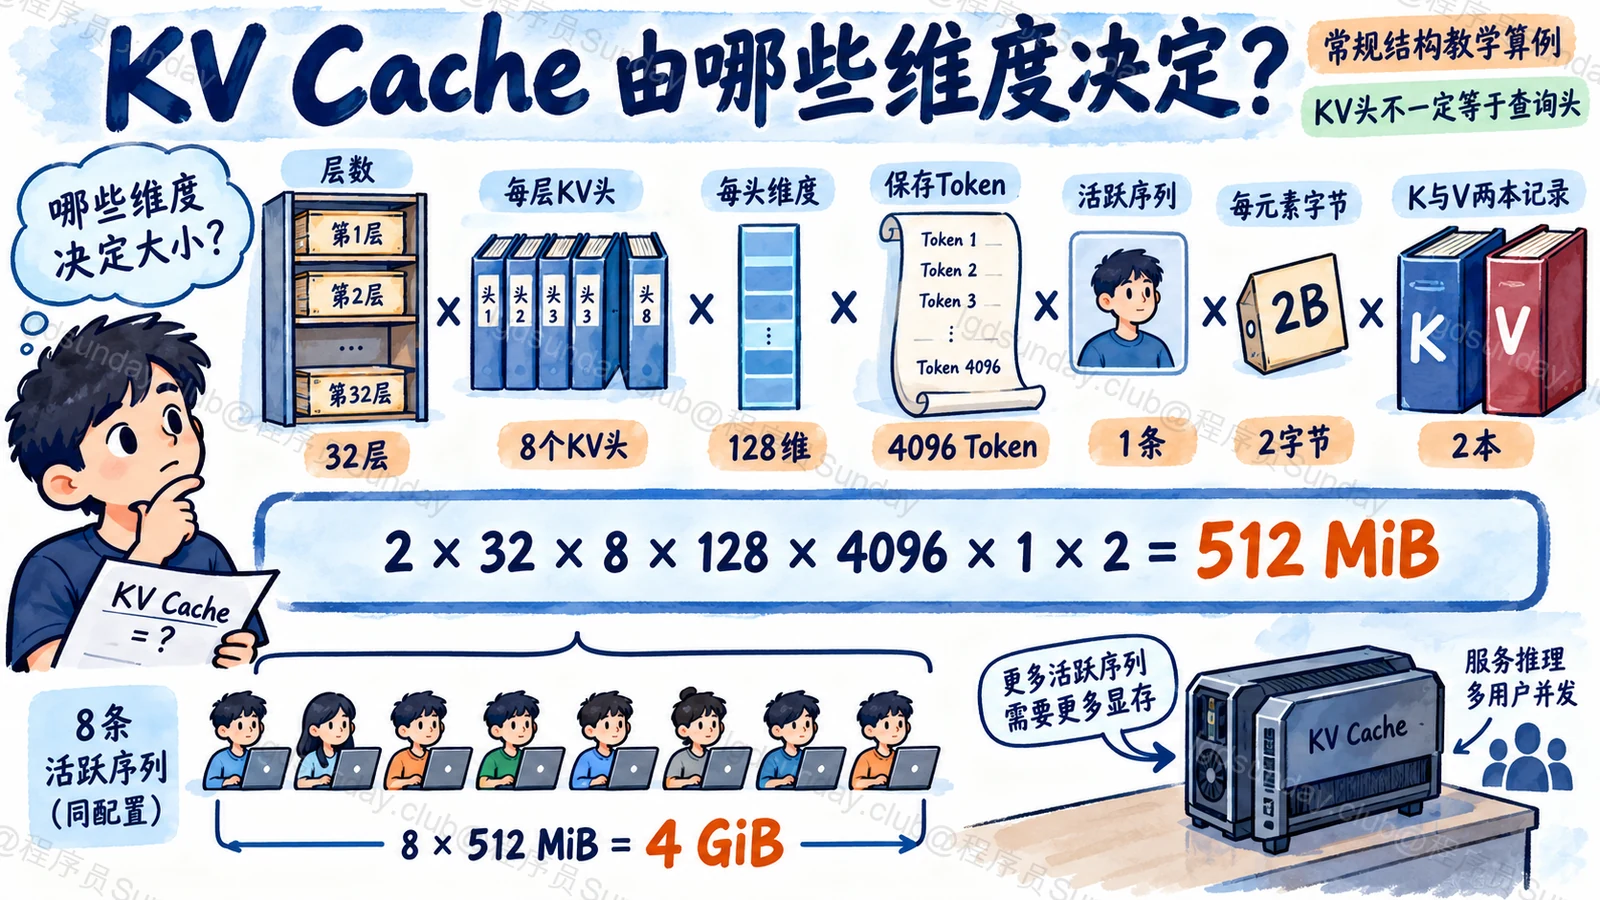
常见自回归 Transformer 为避免重复计算,会保存先前 Token 的 Key 和 Value。对于采用常规 KV 缓存结构的模型,可以用下面的近似公式:
KV 字节数 ≈ 2 × 层数 × KV 头数 × 每头维度
             × 保存的 Token 数 × 活跃序列数 × 每元素字节数
前面的 2 分别对应 K 和 V。KV 头数不一定等于查询头数,采用 GQA 的模型尤其需要区分。滑动窗口、共享前缀、缓存量化或其他注意力结构,还会改变实际估算方式。
Transformers 的缓存文档介绍了不同缓存方案,所以这个公式只是常规结构的起点,不是所有模型的统一公式。
咱们假设一个模型有 32 层、8 个 KV 头、每头 128 维,缓存采用 2 字节精度,每个序列保存 4096 个 Token:
2 × 32 × 8 × 128 × 4096 × 1 × 2
= 536,870,912 字节
= 512 MiB
八个这样的活跃序列约占 4GiB。这个例子没有算块管理等额外开销,也没有假设请求之间共享前缀。保存的 Token 包括需要保留的输入和已经生成的内容,不只是输出长度。
用一个小计算器检查数量级
下面仅计算上述常规 KV 结构。参数应来自模型配置,不要把教学数字直接用于其他模型。
function kvGiB(
  layers: number, kvHeads: number, headDim: number,
  tokens: number, sequences: number, bytesPerElement = 2
): number {
  const bytes = 2 * layers * kvHeads * headDim
    * tokens * sequences * bytesPerElement;
  return bytes / (1024 ** 3);
}
console.log(kvGiB(32, 8, 128, 4096, 8)); // 4
def kv_gib(layers, kv_heads, head_dim, tokens, sequences,
bytes_per_element=2):
size = (2 * layers * kv_heads * head_dim
* tokens * sequences * bytes_per_element)
return size / (1024 ** 3)
print(kv_gib(32, 8, 128, 4096, 8)) # 4.0这不是显存分配器,也没有预测吞吐量。它只用于检查缓存大小和参数变化是否符合预期。
第三笔开销,要靠实际配置测出来
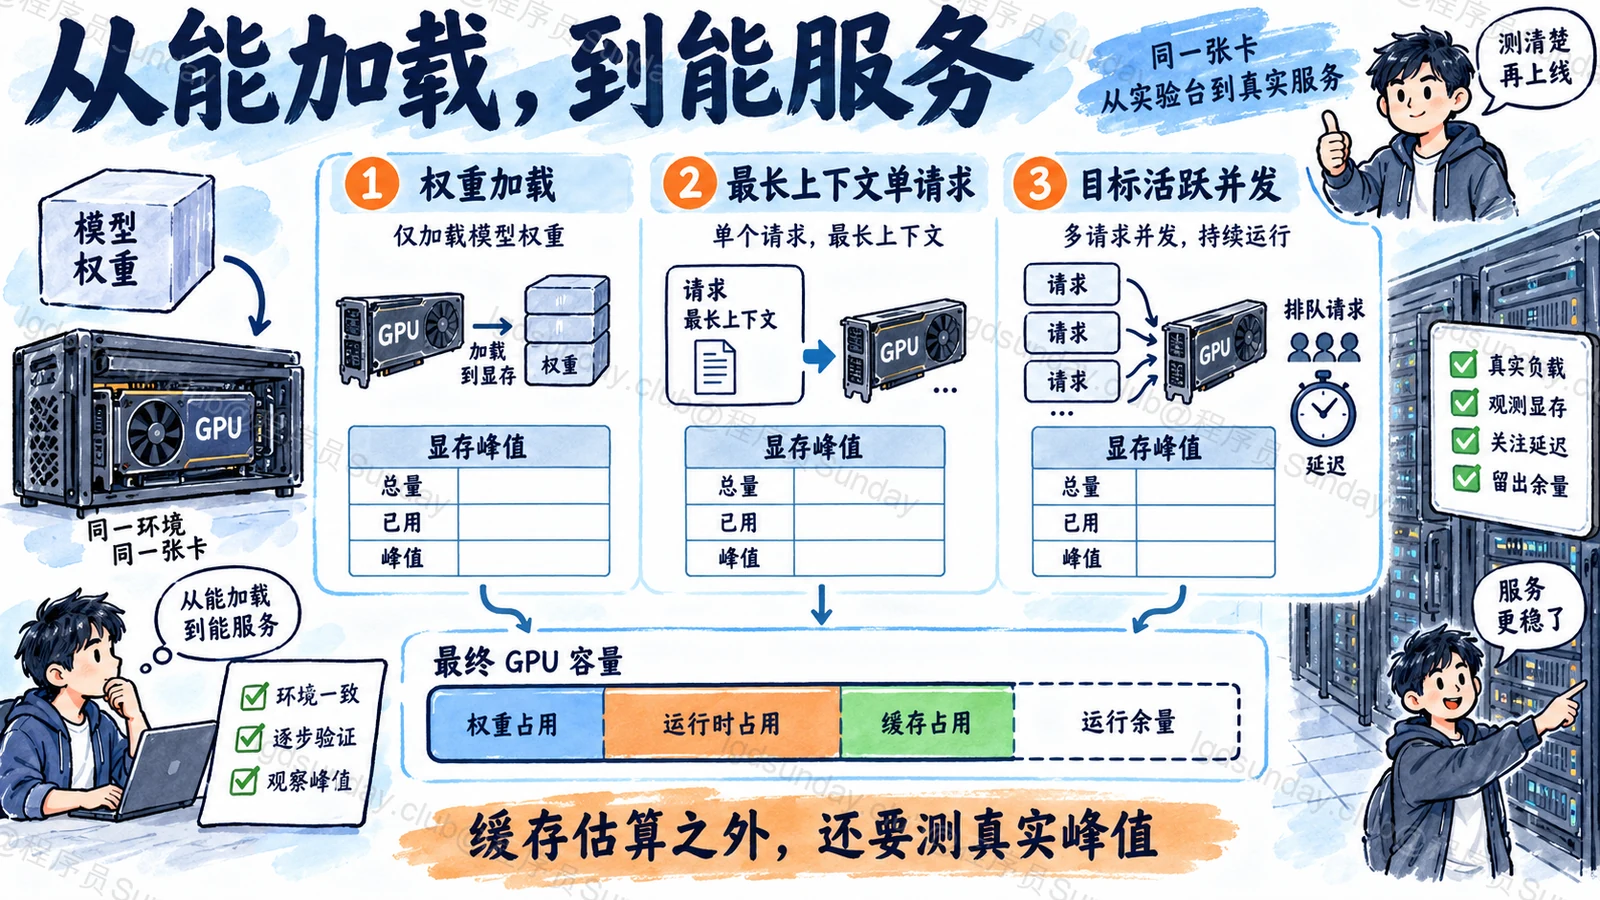
推理还需要临时计算张量、工作区、通信缓冲和引擎自身的管理空间。某些引擎会预留或预分配缓存,观察到的占用与“当前实际 Token 数”不一定线性对应。
因此,不能把权重和缓存相加以后,就声称余下空间一定够用。量化模型也有比例因子等元数据;权重量化不自动意味着 KV 缓存也量化。
更合理的验收是分三步:先确认模型能够加载;再测试目标上下文长度下的单请求峰值;最后测试目标活跃并发及持续运行。
这里的并发指同时占用执行与缓存资源的序列,不是网关接收的所有排队请求。排队机制可以限制活跃数量,但会增加等待时间。容量设计要把显存、吞吐量和延迟一起检查。
面试官继续追问
INT4 模型显存一定是 FP16 的四分之一吗?
理想权重张量的位宽约是四分之一,但总显存还包含量化元数据、非量化张量、缓存和运行开销。不能把权重比例套到整个服务。
上下文翻倍,总显存也翻倍吗?
常规缓存部分可能近似翻倍,权重不会因此翻倍。滑动窗口等结构又会改变缓存行为,需要看具体模型和引擎。
多张卡能把显存简单相加吗?
要看并行策略和模型是否按该策略切分。通信、复制与负载不均衡都会影响可用容量;总显存相加只是设备数量信息,不是部署成功证明。
面试速记卡
- 推理显存:权重、KV Cache、运行开销分别估算。
- 权重起点:参数量乘每参数字节数,区分 GB 与 GiB。
- 缓存变量:结构、精度、上下文和活跃序列数。
- 量化边界:权重减小不等于所有显存同比减少。
- 容量验收:加载、最长请求、活跃并发和峰值分别测试。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →