
CPU 缓存的伪共享是什么?不同线程修改不同变量,为什么仍会互相拖慢?
下面是模拟面试对话,用来讲解本题,不是真实面经。
🧑💻 面试官:两个线程各改自己的变量,会互相影响吗?
🙋♂️ 我:变量不同,没有加锁,应该不会。
🧑💻 面试官:如果变量在同一条缓存行里呢?
🙋♂️ 我:那CPU可能需要协调缓存。
🧑💻 面试官:这种协调会让数据算错吗?给对象多加几个字段,就一定能隔开吗?
线程没有共享同一个变量,也可能共享同一条缓存行;正确性与缓存竞争要分开判断。
面试速答(60 秒版)
伪共享指的是,线程操作不同变量,但这些变量落在同一条缓存行里。CPU维护一致性时按缓存行协调,因此一个核写入后,另一个核的相关缓存副本可能失效,频繁写入就会反复争用这一行。
这会拖慢程序,但不等于一定发生数据竞态。变量是否被安全访问,是正确性问题;是否同处一行,是布局和性能问题。
优化可以考虑减少共享写入、每线程局部累加后合并,或通过合适的布局、填充和对齐隔离热点。不能只加几个无用字段,就断言一定有效。
最后要在真实硬件与运行时上测量,排除调度、锁和内存带宽等因素,再确认修改确实减少了缓存竞争。
知识点详解:不同变量,为什么仍争同一条缓存行
CPU搬运和协调的单位,比一个变量大
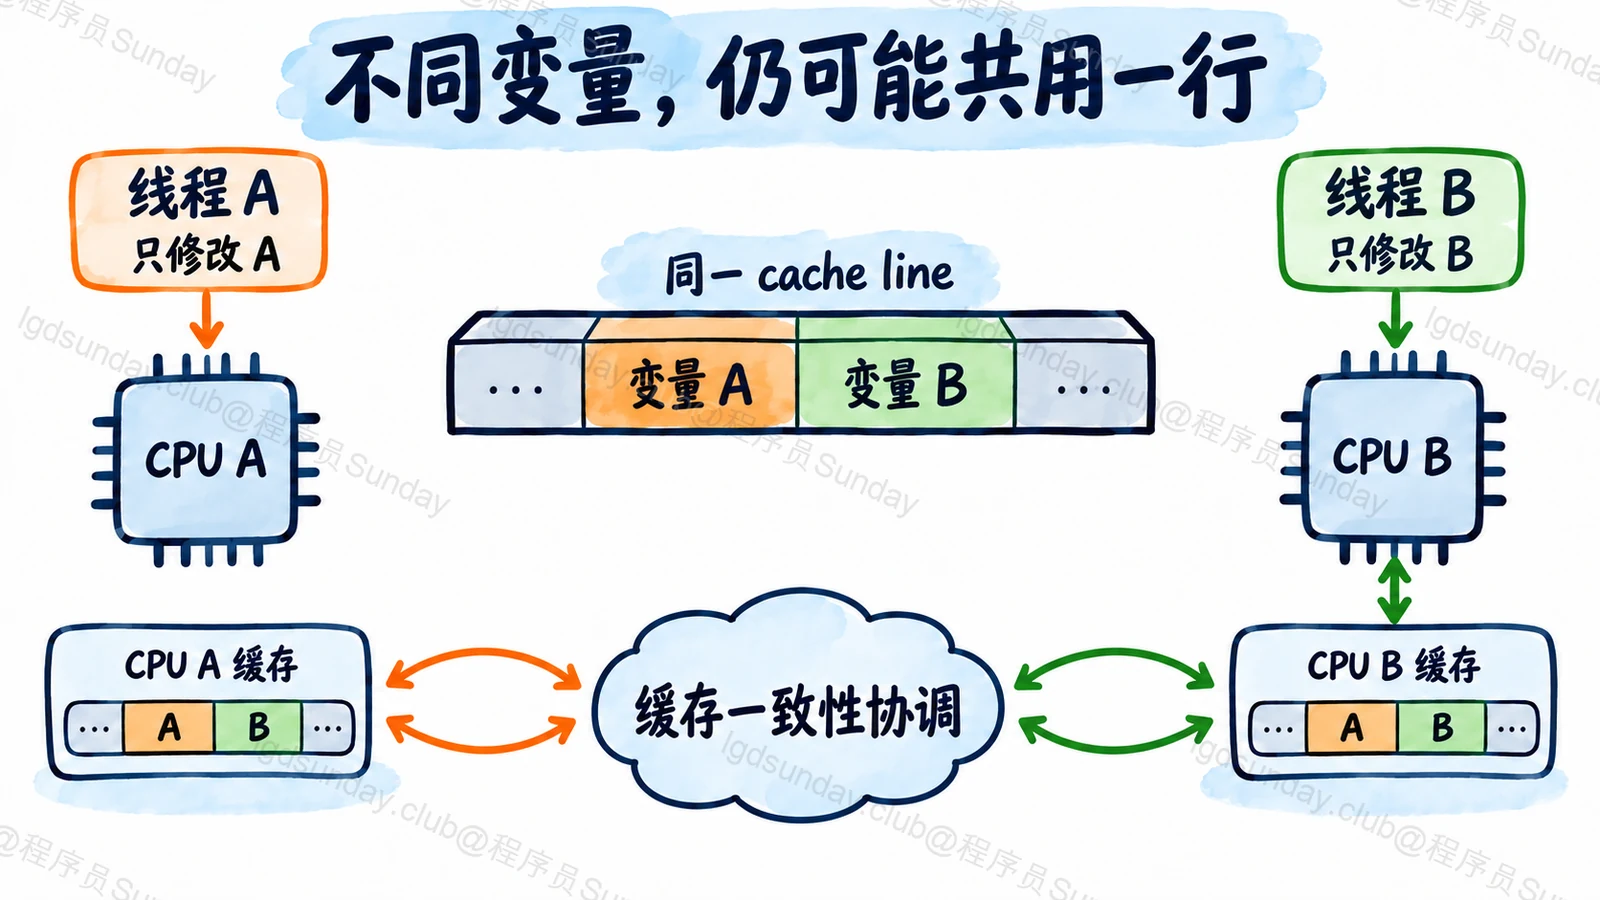
假设计数器A和B各由一个线程写。逻辑上它们独立,但内存布局可能把两者放进同一条缓存行。
CPU读取某个变量时,通常会把所在缓存行带入缓存。另一个核也可能持有这一行的副本。变量名字不同,并不会让硬件自动把它们分成两份完全独立的存储单元。
常见硬件有64字节缓存行,但不能把这个值当成所有平台的固定承诺。讨论具体优化前,要确认目标硬件。
写入交替,就会反复争用缓存行
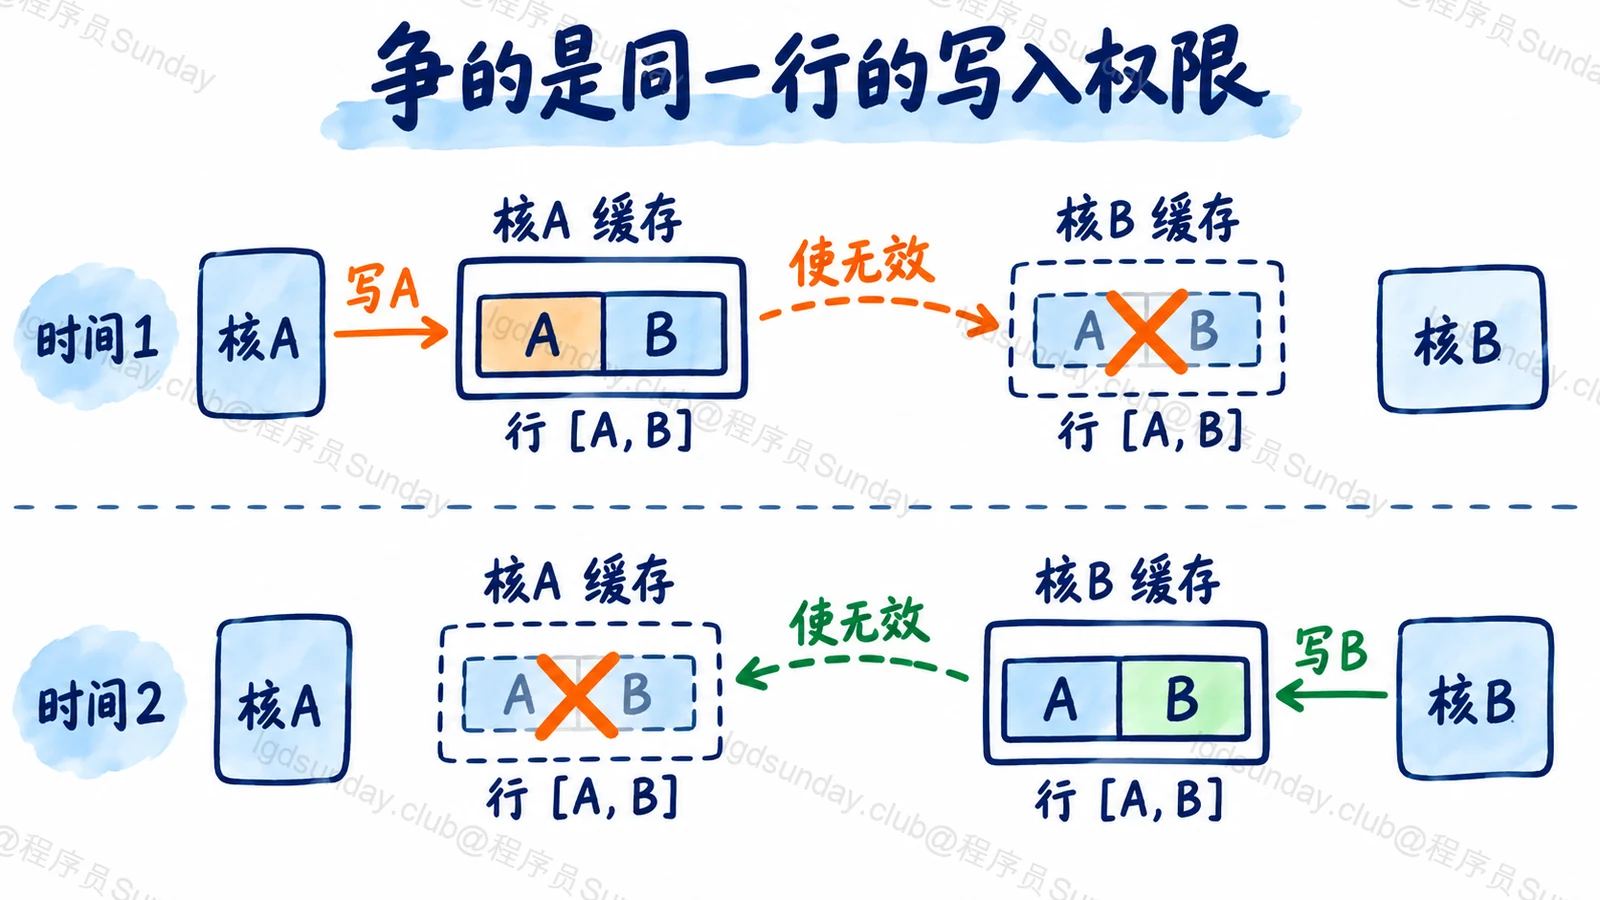
线程A写计数器A,需要获得相应的一致性权限;线程B随后写B,也要取得同一行的权限。这样可能触发副本失效与数据转移,反复协调。
这不是所有缓存同时不断把整行写回主存的简单故事。不同层级和协议实现会影响具体数据传递,解释时抓住“同一行的写入权限反复转移”就够了。
如果只有读,或写入很少,问题未必明显。伪共享通常在多核、频繁写入的热点中更值得检查。
伪共享和数据竞态,是两条判断线
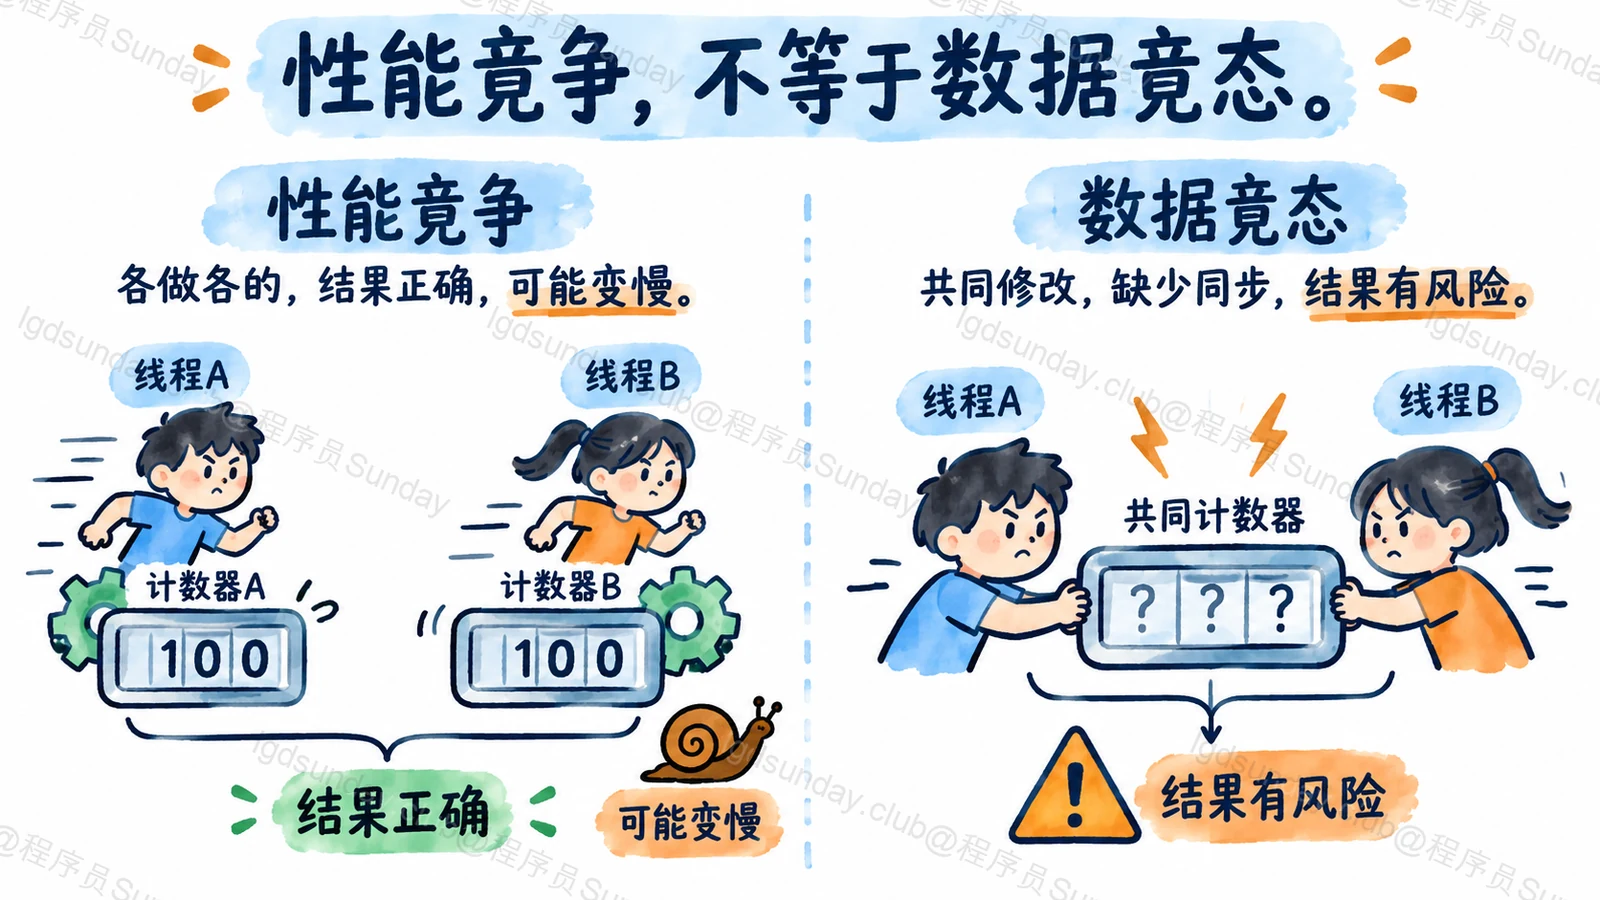
假设两个线程分别写各自独立计数器,访问规则正确,结果可能完全正确,只是变慢。
如果两个线程无同步地修改同一个普通共享计数器,就涉及数据竞态或丢失更新等正确性问题。即便把它放到单独一行,也不能因此修复错误。
因此不要把padding当作锁的替代品。先保证并发语义正确,再研究缓存竞争,顺序不能倒过来。
隔开热点,还要确认真正的内存布局
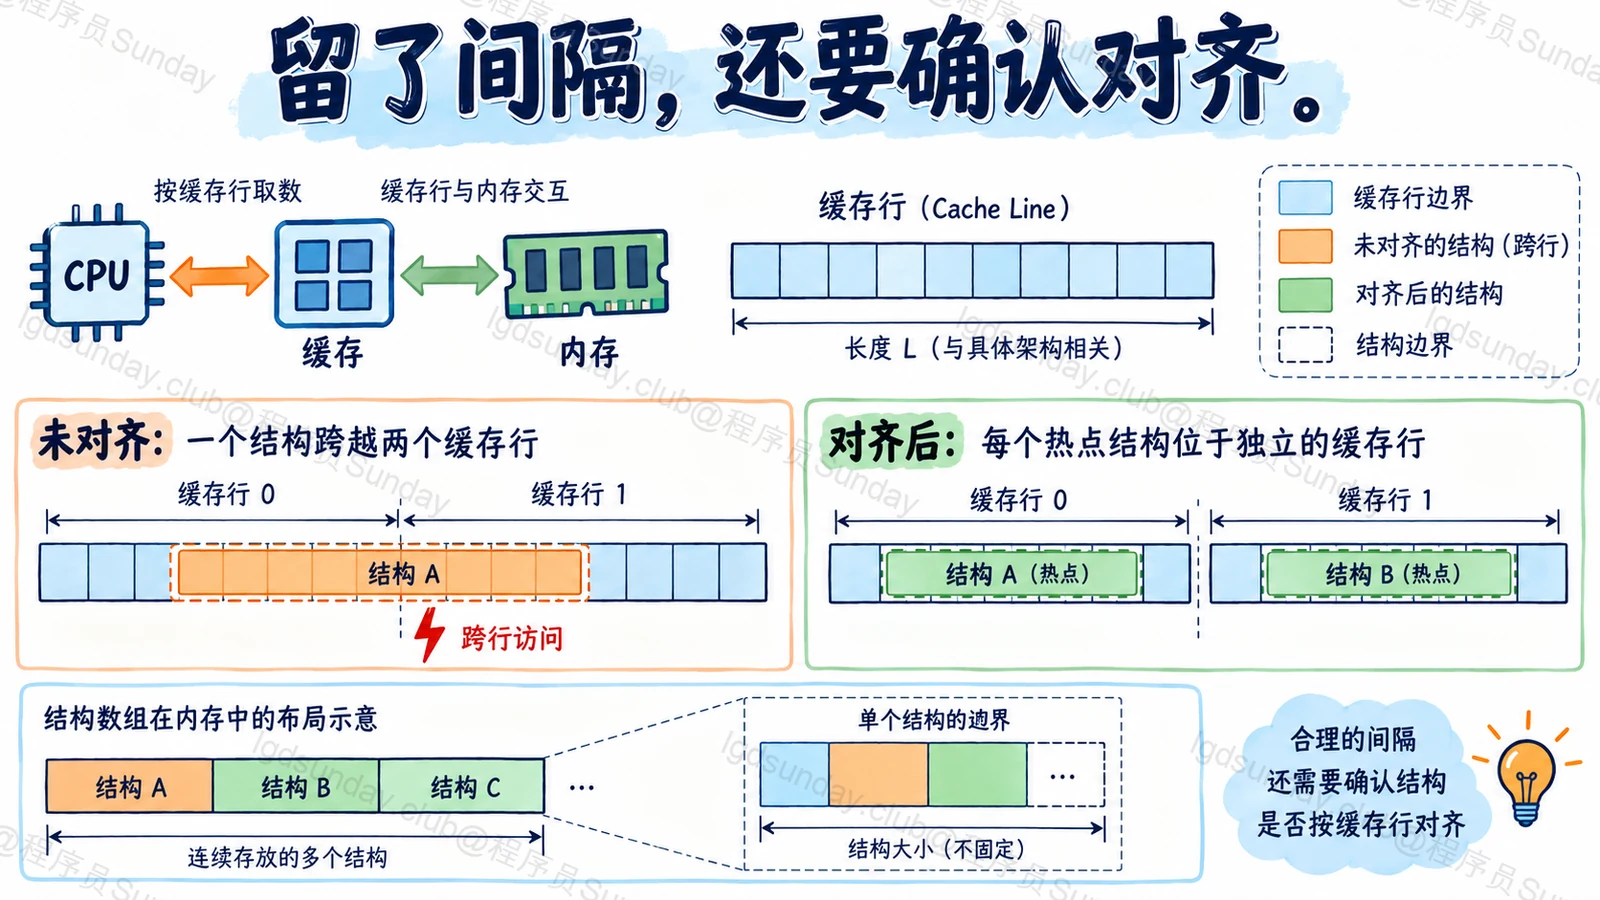
给两个热点之间加填充,可能减少同一行竞争,但对象起点、字段排列和运行时布局都会影响实际结果。Intel官方案例也说明,结构大小刚好等于一条行,不代表数组起点一定对齐。
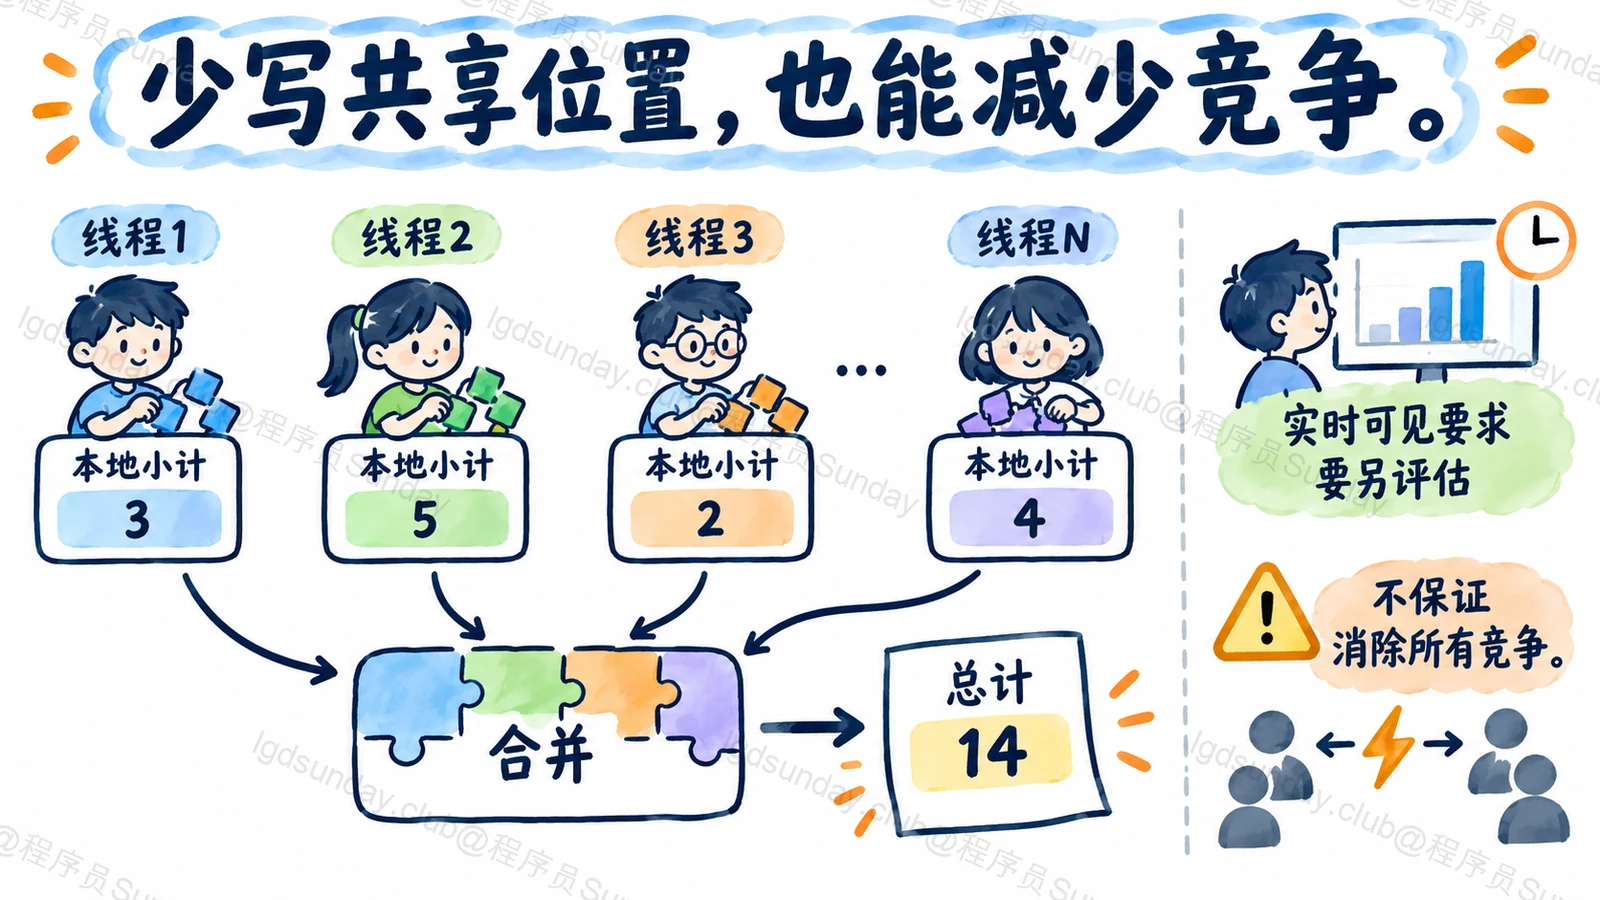
每线程局部累加,再在适当时机合并,也能减少共享写入次数。不过如果要求所有线程立刻读取最新总值,就需要衡量这个方式是否满足语义。
TS普通对象与Python普通对象不能当成精确C结构布局;Python线程实验还会受解释器实现与GIL等影响。本文不提供看似跨语言、实际上无法控制布局的伪基准代码。
证明优化,需要同样工作量的对照
在能控制布局的实现里,对比相邻热点和隔离热点,固定相同计算量,记录多次结果,同时检查线程调度与硬件计数。可以借助VTune或平台支持的缓存竞争工具追具体地址。
如果变快只因为少了计算、减少锁或换了线程数,还不能归因于伪共享消失。
也要考虑代价。过多填充会浪费内存并影响缓存利用率,所以只处理确认的热点,不给每个字段都塞一条缓存行。本文没有复现官方跑分,也不保证相同提升比例。
技术依据:Intel VTune 伪共享示例。工程场景与解法按本文说明的条件展开。
面试官继续追问
volatile能解决伪共享吗?
不能。具体语言中的可见性或访问语义,不会自动把两个字段移到不同缓存行,还可能使写入竞争更明显。
字段隔开后一定更快吗?
不一定。还可能受带宽、调度、锁和真实共享限制,填充也有内存成本,需要对照测量。
面试速记卡
- 单位:缓存一致性通常围绕缓存行,不只围绕变量。
- 触发:独立热点同处一行,多核频繁写入反复争权限。
- 正确性:伪共享不等于竞态,布局优化不替代同步。
- 优化:局部累加、合理隔离与对齐,都要符合业务语义。
- 验证:检查真实布局与硬件证据,不编造跨语言跑分。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
平头哥 · 开发(原帖未明确细分岗位) · 秋招
什么是伪共享,怎样避免?(题意整理)
平头哥 秋招 一面 ↗
原帖发布于 2025-09-22寒武纪 · 深度学习框架开发 · 校招(原帖标签)
并行编程中的 CPU 缓存伪共享是什么?(题意整理)
寒武纪深度学习框架开发一面面经 ↗
原帖编辑于 2020-08-15