
TCP 粘包和拆包怎么解决?长度字段协议如何处理半包和连续消息?
下面是一段教学用的模拟面试。
🧑💻 面试官:发送方 write 两次,接收方能收到两条消息吗?
🙋♂️ 我:不一定,TCP 是字节流,可能合在一次读取里。
🧑💻 面试官:那一条消息也可能分成两次读到?
🙋♂️ 我:会,所以需要消息边界。
🧑💻 面试官:加了长度头就结束了吗?如果这次只收到一半长度头,或者对方声明消息有十几个 GB 呢?
长度头只是协议材料,真正完成拆包的是「保存未完成字节,并反复解析完整帧」。
面试速答(60 秒版)
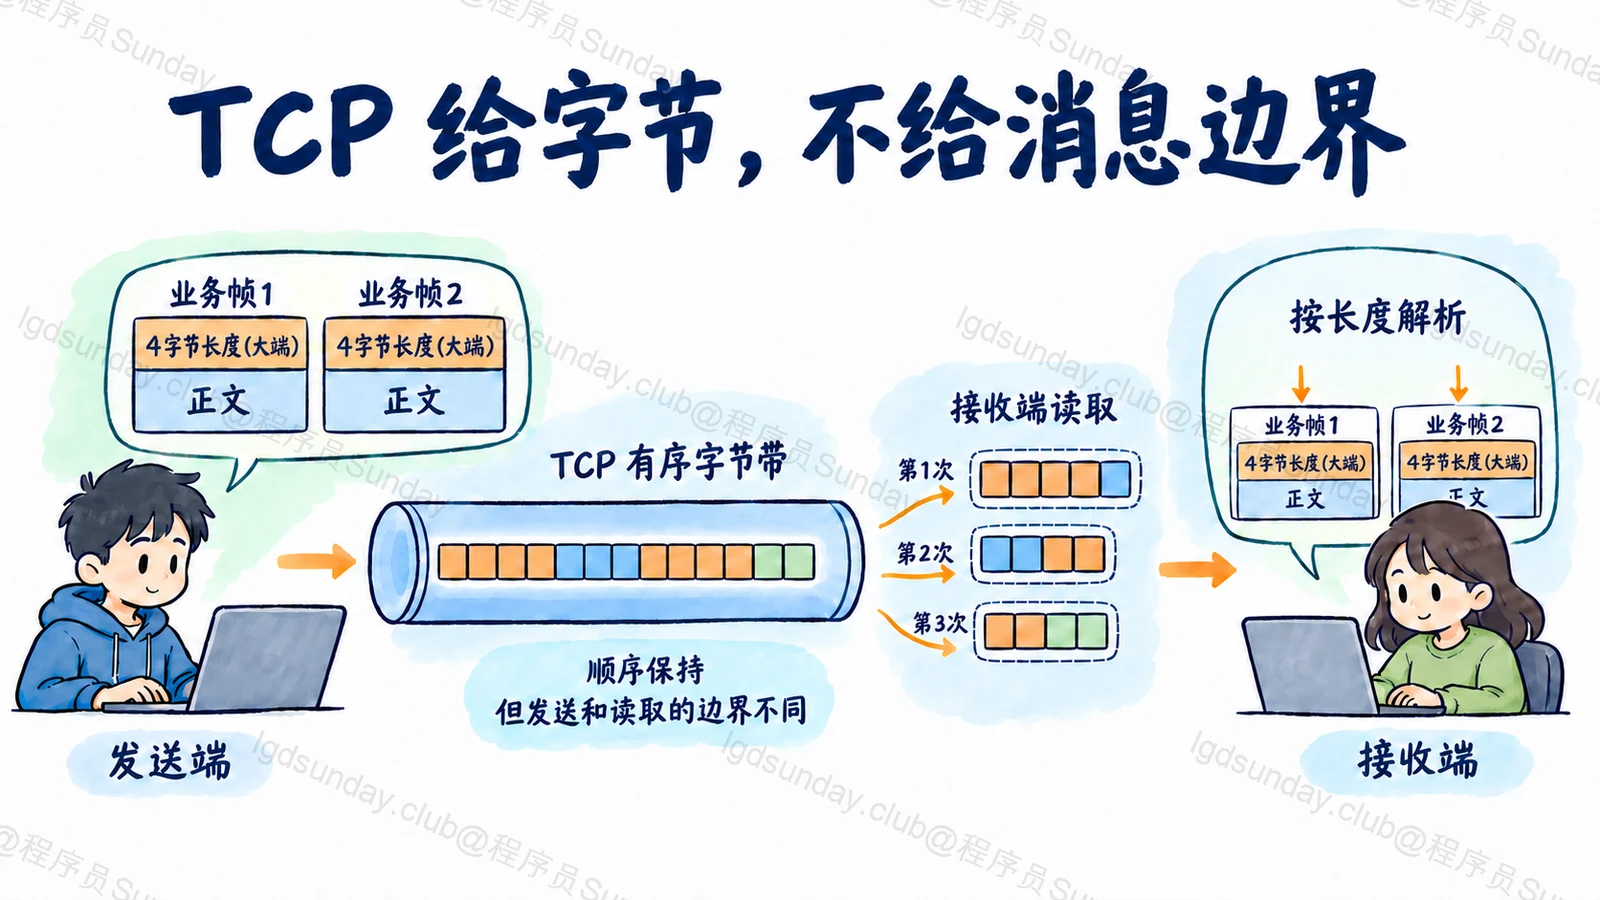
TCP 提供有序的字节流,不保证一次发送对应一次接收。接收方可能一次收到多个消息的字节,也可能分几次才收到一条消息。
解决办法是在应用层定义消息边界,例如固定长度、分隔符或者长度字段。使用长度字段时,接收方先累计字节,读够头部后解析长度,再等到正文完整才交给业务处理。
取出一条以后,还要继续检查缓冲中有没有下一条;不足的字节留到下次读取。同时设置消息长度上限、缓冲与时间限制,断连时检查是否还有不完整数据。不能依靠一次 read 的大小,也不能用字符串字符数充当字节长度。
知识点详解:一次读到了什么,不代表一条消息有多长
先定义帧,而不是猜网络会怎样分段
假设协议规定:前四个字节是无符号大端整数,表示后面正文的字节数。正文是原始字节,可以再按协议解码。
一条正文为三个字节的消息,整帧就是“四字节头 + 三字节正文”。长度不包含这四字节头,这是双方明确约定的选择。
TCP 把这些字节按顺序交付,具体分到哪次读取,没有消息边界承诺。RFC 9293定义的是 TCP 字节流,不是业务帧。
如果正文是中文 JSON,计算长度应使用编码后的字节数,不是字符串里的字符数量。
接收缓冲要保留三种情况
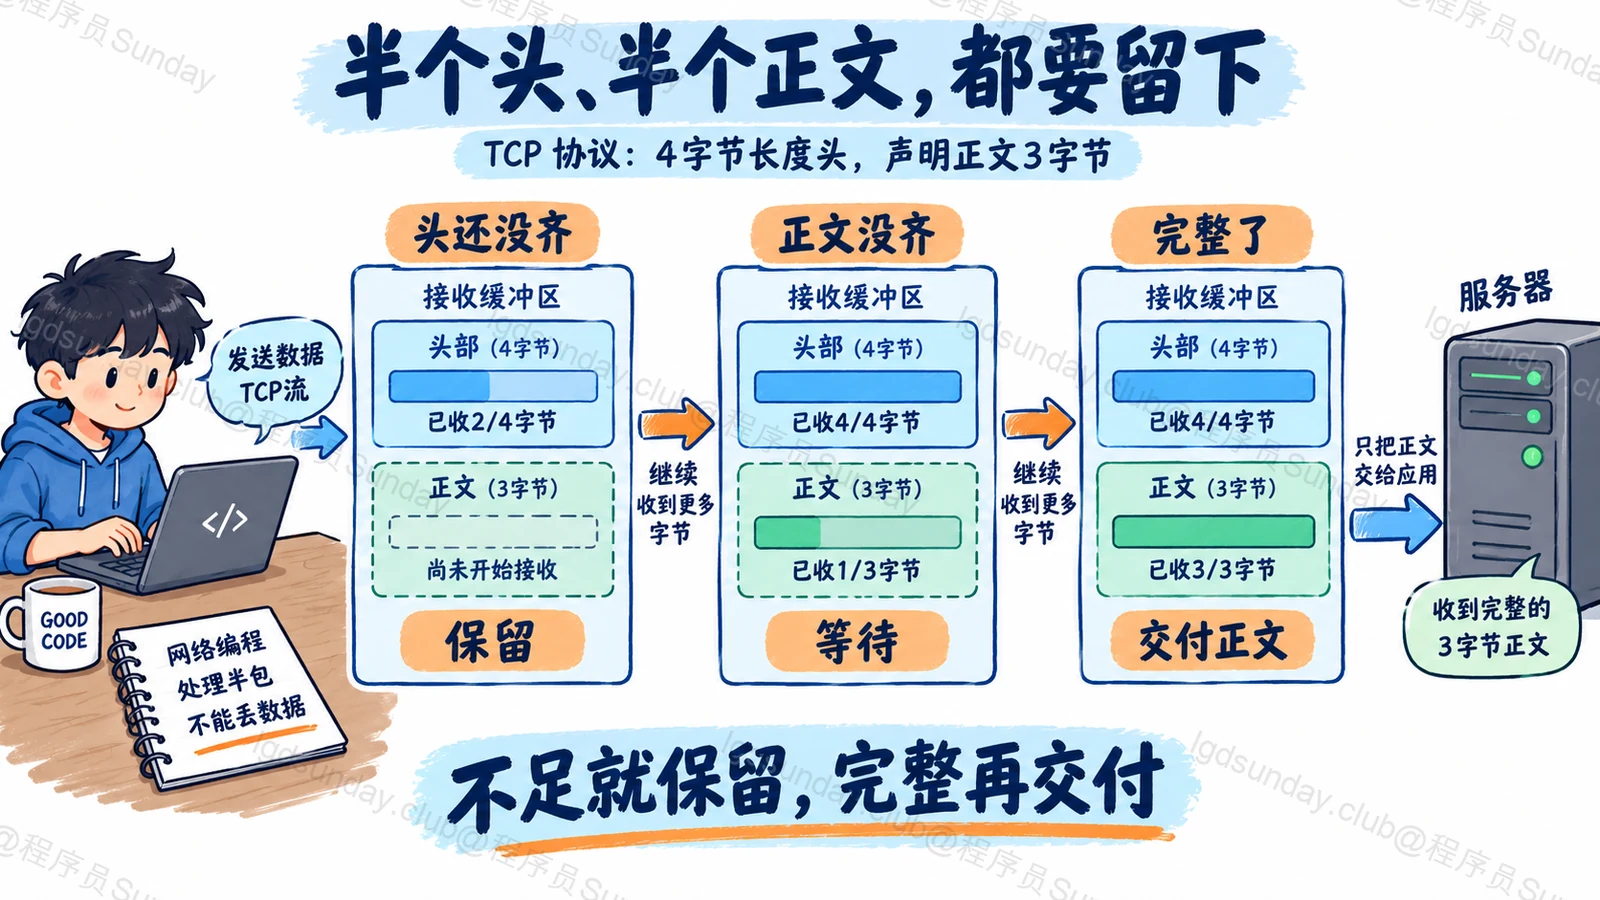
第一种,头部都没收完整:暂时不能知道正文长度,把已有字节留下。
第二种,头部完整,但正文不足:已经知道还差多少,继续等待。
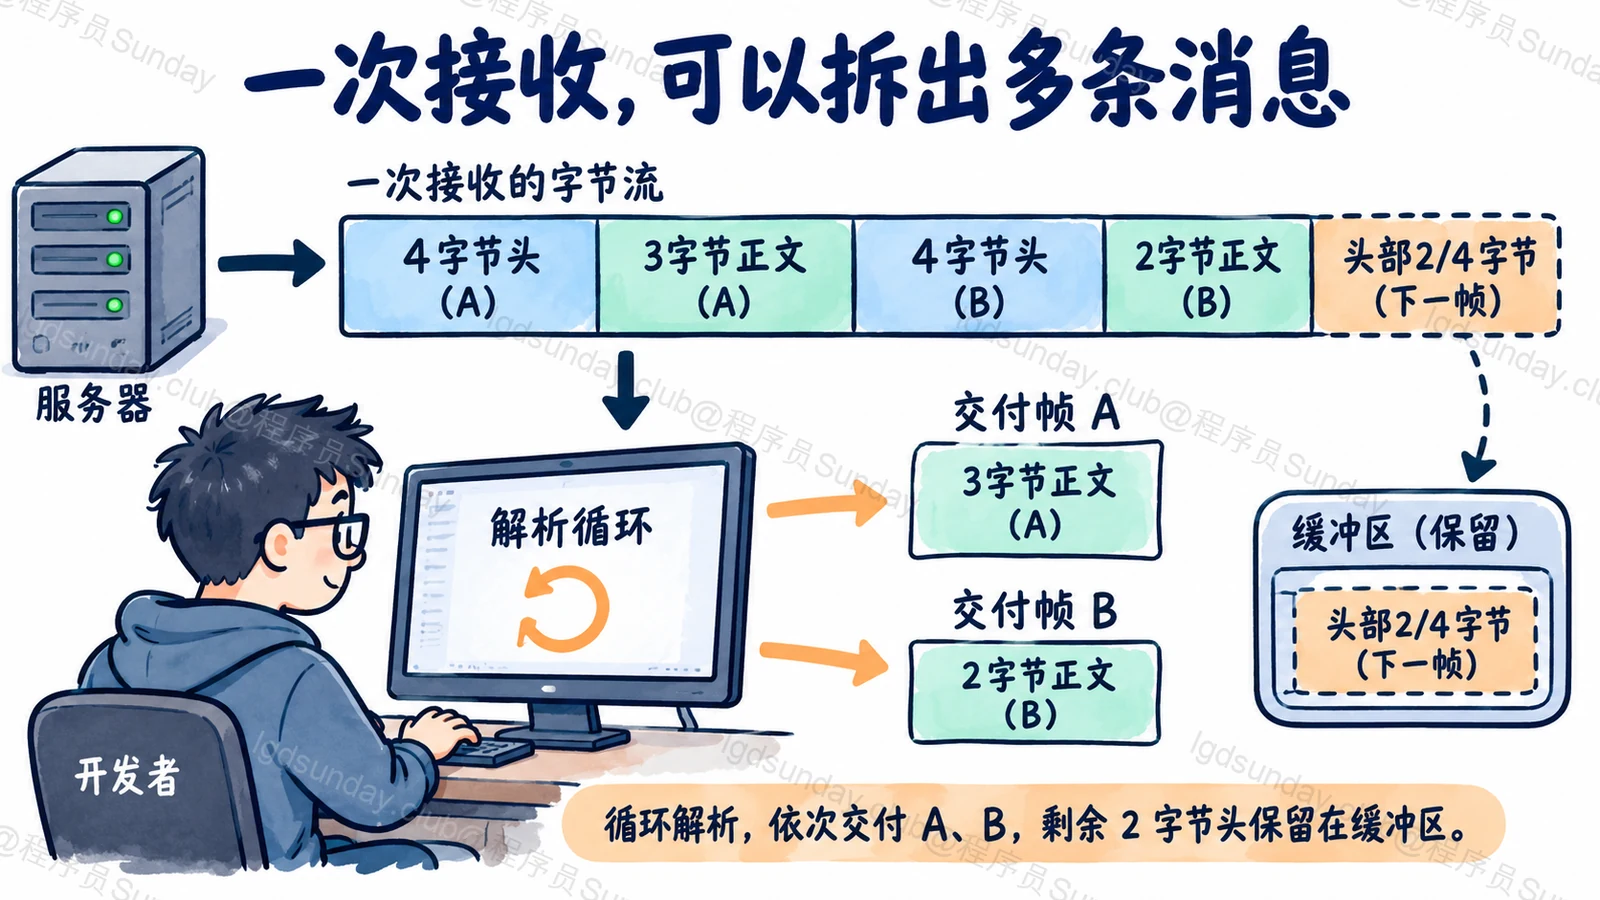
第三种,一条正文完整:取出这条,剩下的可能是下一条完整帧,也可能只是下一条的半个头。继续解析,直到剩余内容不够。
所以解析器应使用循环,而不是一个 if。也不能每次收到数据就把缓冲清空。
一个最小解析器,怎样保存未完成数据?
下面两份实现使用同一协议。为了展示边界,单帧正文限制为 1 MiB,示例单次输入限制为 2 MiB。真实 socket 的读取块还应保持合理大小;生产环境需要更高效的缓冲管理。
import { Buffer } from 'node:buffer'

export class Decoder {
  private pending = Buffer.alloc(0)
  private readonly max = 1024 * 1024

  feed(chunk: Buffer): Buffer[] {
    if (chunk.length > this.max * 2) throw new Error('chunk too large')
    this.pending = Buffer.concat([this.pending, chunk])
    const frames: Buffer[] = []
    while (this.pending.length >= 4) {
      const size = this.pending.readUInt32BE(0)
      if (size > this.max) throw new Error('frame too large')
      if (this.pending.length < 4 + size) break
      frames.push(Buffer.from(this.pending.subarray(4, 4 + size)))
      this.pending = this.pending.subarray(4 + size)
    }
    return frames
  }

  finish(): void {
    if (this.pending.length !== 0) throw new Error('truncated frame')
  }
}
class Decoder:
def __init__(self):
self.pending = bytearray()
self.max_size = 1024 * 1024
def feed(self, chunk: bytes) -> list[bytes]:
if len(chunk) > self.max_size * 2:
raise ValueError("chunk too large")
self.pending.extend(chunk)
frames = []
while len(self.pending) >= 4:
size = int.from_bytes(self.pending[:4], "big")
if size > self.max_size:
raise ValueError("frame too large")
if len(self.pending) < 4 + size:
break
frames.append(bytes(self.pending[4:4 + size]))
del self.pending[:4 + size]
return frames
def finish(self) -> None:
if self.pending:
raise ValueError("truncated frame")feed 返回这次已经完整的消息,未完成部分继续保留。finish 用于输入流确定结束时,检查有没有残留半帧。本示例允许零长度正文;如果业务不允许,应再增加相应校验。
一旦发生长度或格式错误,应终止这条连接的解析流程,而不是忽略错误、继续按未知边界拆数据。
长度有限,还为什么需要时间限制?
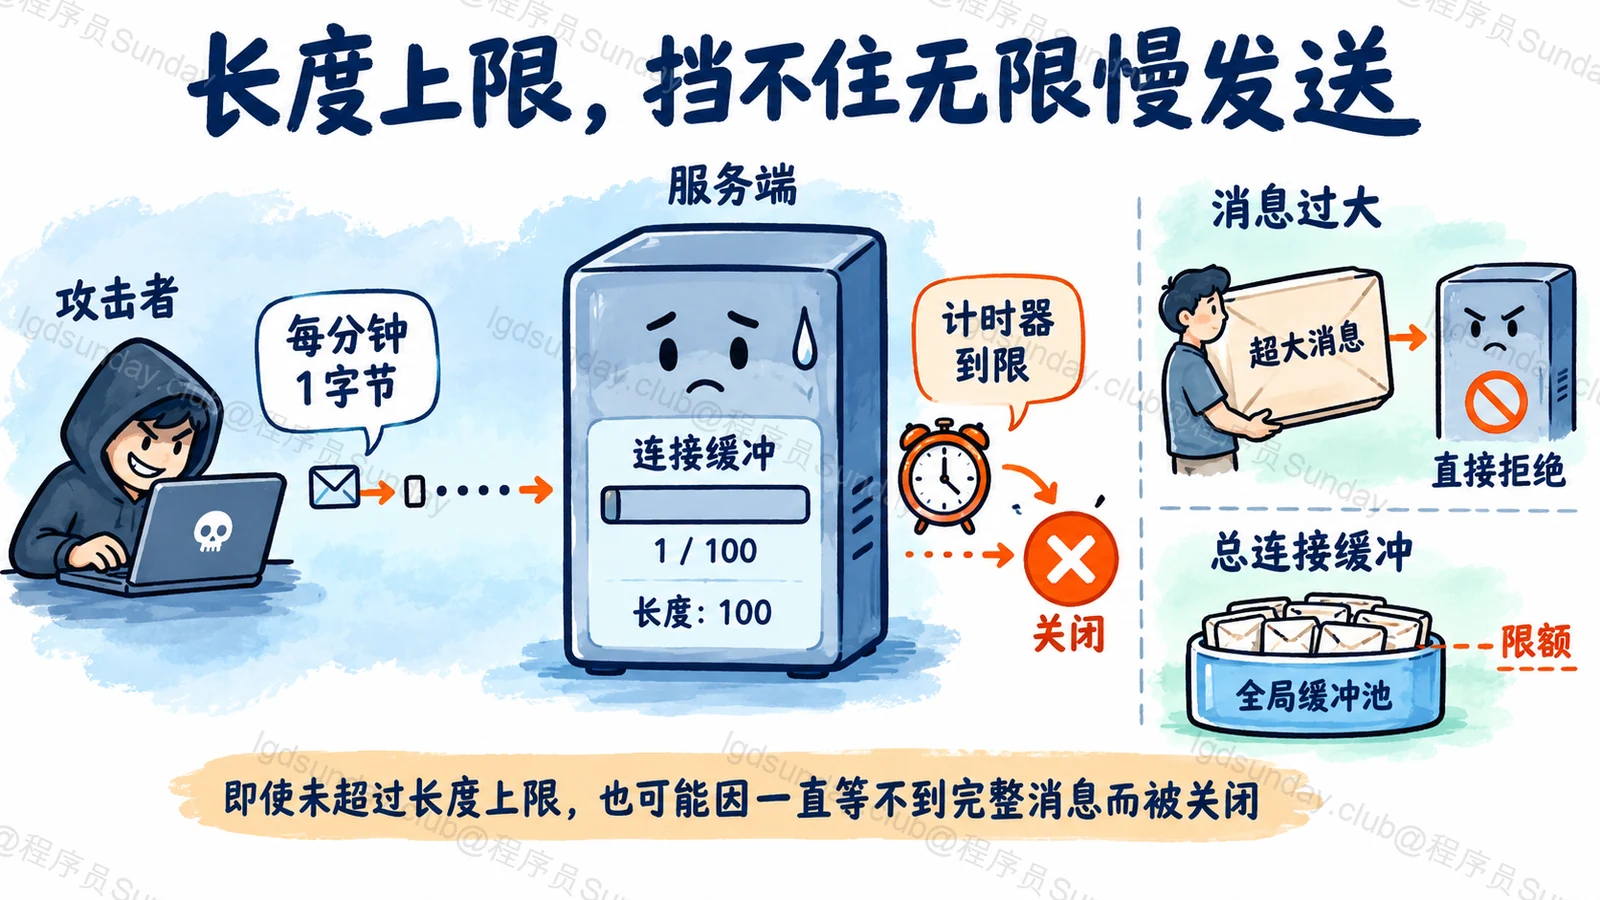
对方声明正文一百字节,每分钟只发一个字节,虽然没超过长度上限,仍可以长时间占用连接和缓冲。
因此,还要限制读头、读正文或连接空闲的时间,同时限制连接数量和总缓冲规模。每条连接“最多一兆”乘上大量连接,仍然可能占满进程。
示例也使用了重复拼接和切片,便于教学,不是高吞吐最终实现。实际可以使用读写游标、分段缓冲等方式减少复制。
面试官继续追问
禁用 Nagle 算法,可以解决粘包吗?
不能。它可能影响发送时机,但 TCP 仍然没有业务消息边界。接收方依然必须遵守帧协议。
正文没读完就断开,能把已收到的部分交给业务吗?
不能当作完整消息提交。应报告截断,并按业务协议决定是否重试。重试还要处理幂等,不能把传输完整性当成业务恰好执行一次。
如何测试解析器?
把两条编码好的帧连续输入,再把同一批字节在每个可能位置切开输入。结果必须完全一致。还要测半个头、半个正文、超长声明、空正文和截断结束,而不只测一次完整读取。
面试速记卡
- TCP:有序字节流,发送次数不等于接收次数。
- 协议:长度字段的大小、字节序与计数范围必须明确。
- 缓冲:不足就保留,完整就取出,再继续解析下一条。
- 限制:消息长度、单次输入、总缓冲与等待时间分别控制。
- 结束:有残留半帧不能当完整消息处理。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →